Bloom filter nima va qanday ishlaydi?
Assalamu Alaykum bugun Bloom filters nimaligi haqida gaplashamiz. Bloom filter nima ekan ? Yana yangi buzzwordmi deganlar uchun bu maqola ayni muddao.
Bloom filter
Bloom filter bu xotira samaradorligi yuqori bo'lgan ehtimollik data strukturasi. U bizga ushbu katta savolga javob berishga yordam berish uchun kerak , “ Qidirilayotgan element ushbu to'plamda bormi ? ’’ . Uning javobi esa aniq yo’q yoki bo'lishi mumkin bo'ladi. Va xuddi shu qismi ehtimollikga kiradi.
Dasturlashda har doim bo'lganidek bu yerda ham trade off (ikkalasidan bittasini tanlash) xotira yoki aniqlik o'rtasida .
U Nosql databazalarda databaza bo'lmagan keylarni tekshirish uchun ishlatiladi, Chromeda esa xavfli saytlarni aniqlash uchun ishlatilingan.
Muammo
Biz bir ma'lumotni to'plamdan topishimiz kerak ?
1-yo'l Linear usul
Bu yerda siz har bir elementni tekshirishingiz kerak bu kichik miqdorga ega to'plamlar uchun yaxshi ammo , ularni soni ko'paysa vaqt ko'payadi.
2-yo'l Hashmap usul
Bunda siz ma'lumotlarni array sifatida saqlab borasiz va kerak bo'lganda key orqali uni bor yoki yo'qligini tekshirishimiz mumkin. Ammo ma'lumot ko'paysa u bu juda ko'p xotirani oladi va bizga bu kerak emas .
3-yo'l Bloom filters
Bunda siz xotiradan bir qancha joy ajratasiz va 0lardan iborat bo'ladi hamda sizga bir yoki bir nechta hash funksiyasi kerak u orqali berilgan stringlarni biz raqamlarga ajratib olamiz. hash funksiya bir xil qiymatga doim bir xil natija qaytarishi kerak. Va bizga qaytarilgan raqamlardagi bitlarni 1 ga o'zgartiramiz. Va shu string tekshirish uchun qayta kelganda biz uni hash funksiyalarda o'tkazamiz va uni bloom filterdagi bitlar bilan solishtiramiz , agar ularning birortasi 1 bo'lmasa demak bu qiymat bizni to'plamda mavjud emas. Ammo hammasi 1 bo'lganda ham u qiymat to’plamda bo'lmasligi mumkin bu false positive deyiladi . Bunga sabab u bitlarni boshqa qiymatdagi hash funksiyalar 1ga aylantirgan bo'ladi.
Bu usulni ko'pincha username bormi yoki yo'qligini tekshirish uchun ishlatilinadi (boshqa joylarda ham bemalol ishlatsa bo'ladi) .
Keling buni shu misol bilan yaxshilab ko'rib chiqamiz.
Muammo ushbu username databazada bormi yoki yoqligini tekshirish.
Boshida biz shunchaki frontenddan kelgan so'rovni backendga yuboramiz va natijani olib qaytaramiz , ammo databazadagi ma'lumotlar ko'paysa bu sekin bo'ladi , Buning tezligini oshirish uchun redisni cache sifatida qo'shamiz . Bu ancha tez bo'ladi ammo redis databaza bilan sinxronlashdan chiqib ketsa so'rovlar yana tabazaga borishni boshlaydi va bizda xotira oshadi. Hamda cache dasturga ancha murakkablik qo'shadi.
To'g'ri databaza indexlansa hamda sizda yaxshi performancega ega query bo'lsa natijani tez olishingiz mumkin ammo bu qimmat chunki har bir databazaga tcp ulanish ham boshqa querylarga ta'sir qiladi.
Va buni bloom filter orqali hal qilish mumkin u juda kam joy olgan holda sizga databazada ushbu ma'lumot yoqligi haqida aniq ma'lumot bera oladi. Bu yerda hash funksiyalar ham vaqt oladi ammo xotiradan ancha tejaladi.
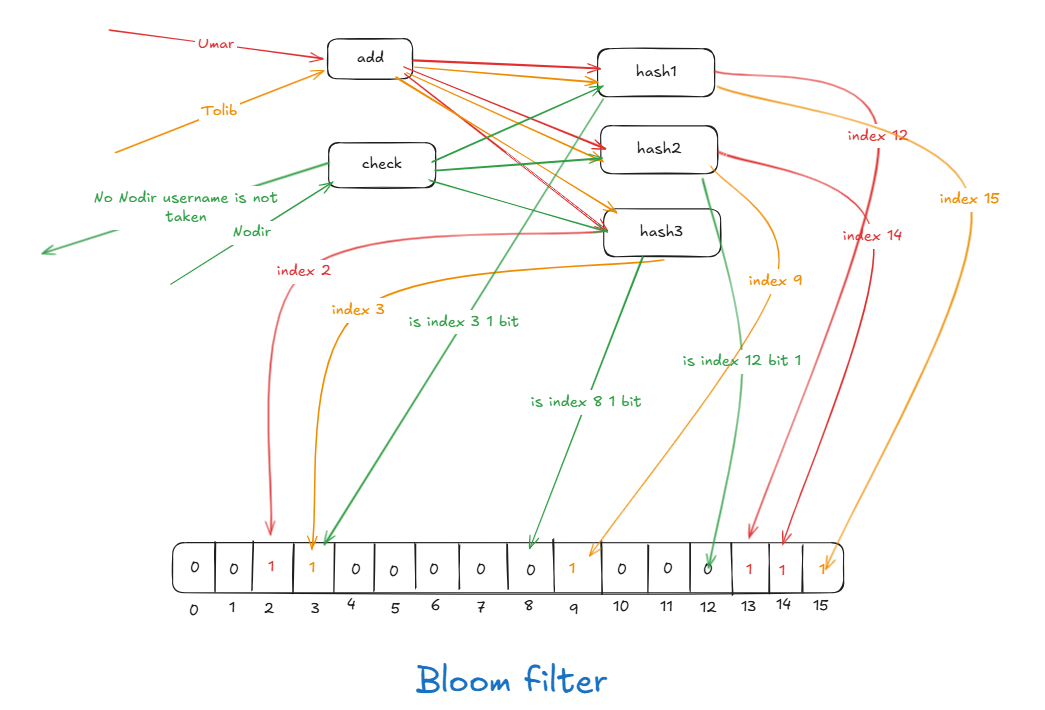
Ba’zan siz databazada bo'lmagan qiymatga ham bo'lishi mumkin degan javob olishingiz mumkin. Buni beriladigan bitlar soni hash funksiyalar sonilar ozgartirish orqali yaxshilash mumkin. Bu yerda to'g'ri miqdordagi xotira tanlash juda muhim.
Ammo bizda bitta muammo bor agarda databazadagi ma'lumot o'chirilsa nima bo'ladi ? U bloom filterdan o'chiriladimi (ammo u boshqa qiymatga ham bog'liq bo'lishi mumkin) . Va qanchadir vaqt o'tgandan so'ng ko'p qiymatlar 1 ga aylanib qolganligi tufayli databazaga borish ko'payadi(saturation problem) . Bu muammoni ham yechish kerak.
Birinchi muammoni vaqti vaqti bilan bloom filterni qayta yaratish databazaga asoslangan holda yechim bo'lishi mumkin.
2-muammoga esa bit arrayni qaysidir foizdan (70%) o'tsa bloom filter kattarog'i bilan almashtirilishi mumkin.
Xulosa
Xuolsa qilib aytadigan bo'lsak bir guruh ma'lumotdan u bizda yo'qligini tez va kam xotira olgan holda topish kerak bo'lsa bloom filter eng yaxshi varian hisoblanadi.