Database partitioning nima? PostgreSQLda demo bilan
Assalamu Alaykum bugun databaza partitioning nimaligi va u bizga qanday foydalar olib kelishi haqida to'liq gaplashamiz. Va uni amalda ishlatib ko'ramiz.
Database partitioning nima ?
Database partitioning bu katta jadvallarni kichik jadvallarga bo'lgan holda saqlash texnikasi va o'qish jarayonida ma'lumot qayerda bo'lishiga qarab databaza o'sha jadvalni tanlaydi .
Masalan tasavur qiling siz Telegramga o'xshagan ijtimoiy tarmoqsiz va sizdagi foydalanuvchilar soni juda ko'p (milliardga yaqin) va siz userIdsi 70000000 bo'lgan foydalanuvchini olmoqchisiz , bizda index bo'lsa uni skanerlab tog'ri shu user bor pagega boramiz . Ammo katta jadvallarda indexni tekshirishni o'zi ham ko'p vaqt oladi hamda index kattalashganligi sababli tezkor xotiraga sig'may qolishi mumkin. Shuning uchun bizga jadvallarni partitioning (qismlarga ajratish) qilish orqali kichikroq jadvallarga bo'lish yordam beradi . Bu bir xil sxemaga ega ammo ko'p jadvallar bo'ladi . Biz buni bir umumiy User jadvalga bog'lashimiz mumkin (unda faqat jadvallar ma'lumoti bo'ladi) . Va biz queryni qaytalasak u faqatgina ushbu qator bor jadvalni qidiradi va query ancha tezlashadi chunki kam qator(row) bilan ishlanmoqda .
Bizda Vertical va Horizontal partitioning mavjud.
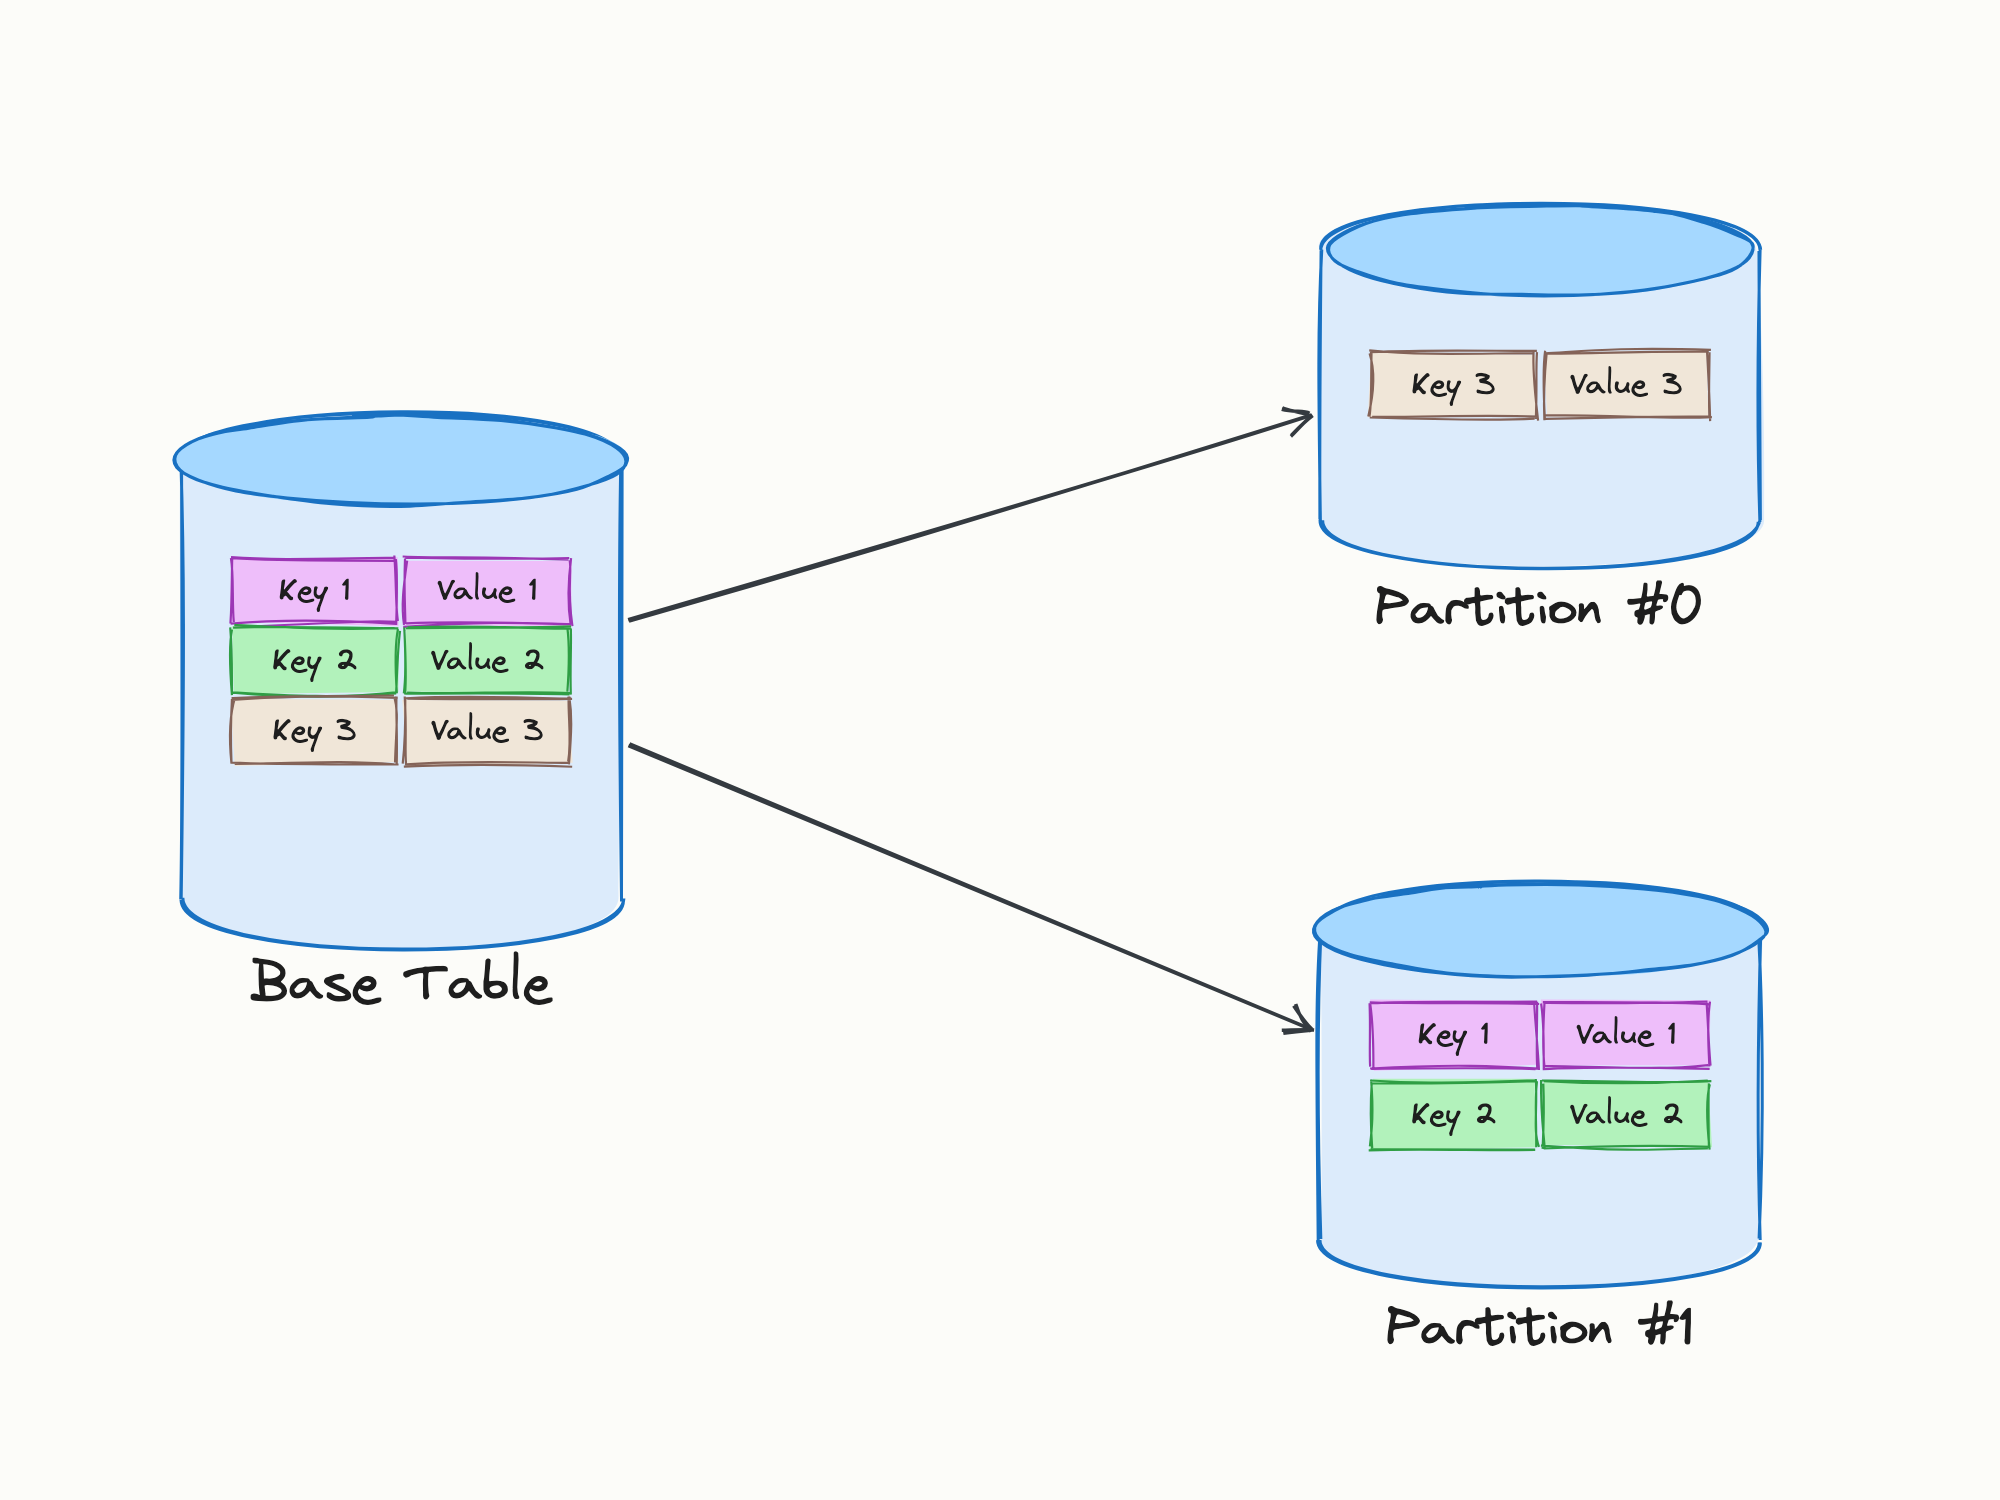
Vertical and Horizontal partitioning
Horizontal partitioning bu jadvalni qatordagi qiymatlarga (oraliq yoki list) qarab bo'lishga aytiladi .
Vertical partitioning bu jadvalni ustun(column) bo'yicha bo'lishga aytiladi. Bu bizga qachonki bizdagi bir ustundagi qiymatlar katta bo'lsa va ular kam query qilinsa o'sha ustunni boshqa jadvalga partitionning qilsa bo'ladi. Bu xuddi boshqa jadval yaratib uniga foreign key orqali ushbu tablega bog'lab qo'yishga o'xshaydi . Xo'sh qaysi birini qachon tanlaymiz ?
Vertical partitioning bir mantiqiy jadvalni o'qishni osonlashtirish uchun ishlatilinadi . Unda eng ko'p ishlatilinadigan ustunlar birgalikda guruh qilib partition qilinadi . Bu faqatgina sizda juda ko'p kam ishlatilinadigan column bo'lsa yordam beradi.
Alohida jadval va foreign key esa bir biriga aloqador ikkita jadvalni bog'lash uchun ishlatilinadi ayniqsa one to many yoki optional bog'lanishlarda. Normalization haqida ko'proq bilmoqchi bo'lsangiz ushbu maqolani o'qishni taklif qilaman.
Database Normalization formalari.
Partition Turlari
Databaza bo'lishnin har xil usullari bor :
Range (oraliq ) orqali— Ma'lum sanalar masalan yil bo'yicha yoki oylar bo'yicha. Yoki har 10 million id dan keyin yangi partition yaratish.
Ro'yxat orqali — Ma'lum bir berilgan ro'yxat bo'yicha guruhlash (viloyatlar , davlatlar, zip kodlar) .
Hash funksiyalar orqali— Bu hash funksiya orqali partition qilish ya'ni, sizdagi qiymatlar har doim raqam yoki list bo'lmaydi ular string bo'lishi ham mumkin , hash funksiya siz bo'layotgan ustun qiymatini hashlab o'sha bo'yicha har xil kichik jadvallarga bo'ladi . Hamda bu partitionlar bo'yicha ma'lumotlar teng taqsimlanishiga yordam beradi. Bu consistent hashing deyiladi.
Consistent hashing haqida keyingi maqolalarda batafsilroq yoritamiz.
Demo
Demo uchun docker postgres container yaratib olamiz.
docker run --name partition-test -p 20000:5432 -d -e POSTGRES_PASSWORD=postgres postgres:latest //container yaratish va ishga tushirish
docker exec -it partition-test psql -U postgres //postgresga kirish uchun
Bundan so'ng 10 million qator ma'lumotni ushbu bazaga joylaymiz.
Kodni ushbu repostoridan topishingiz mumkin (nodejsda) . Repo
Va unda index ham yaratamiz :
CREATE INDEX students_grade_idx on students(grade);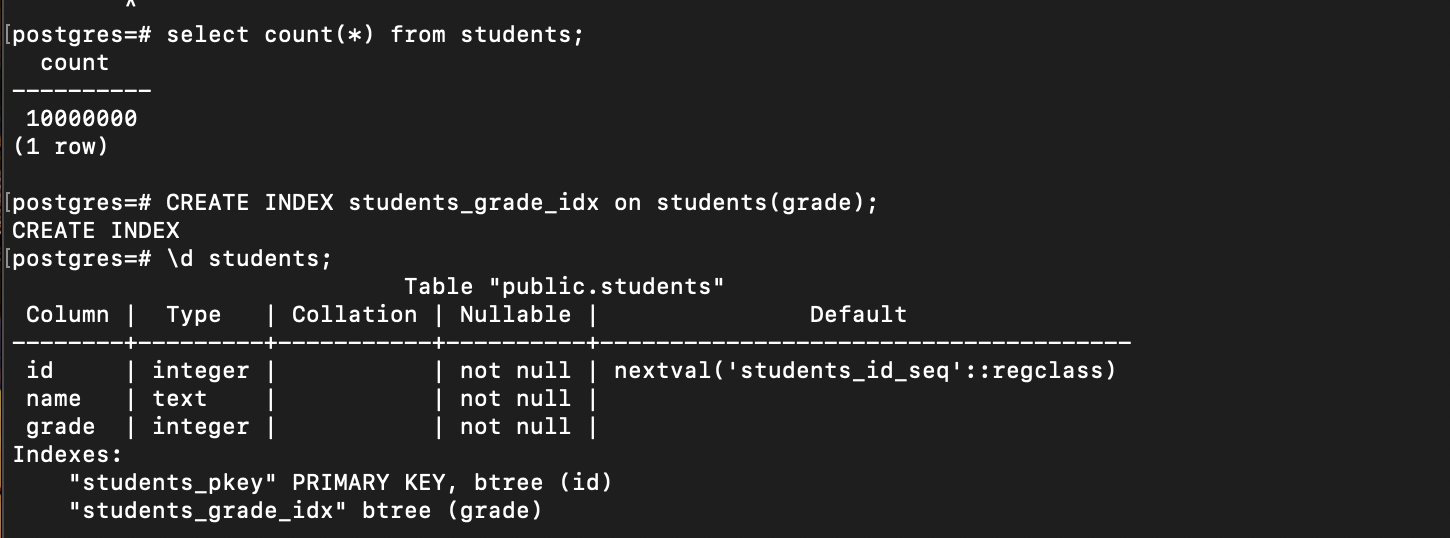
Bir necha query run qilib ko'ramiz.
EXPLAIN ANALYZE SELECT COUNT(*) FROM students WHERE grade = 42;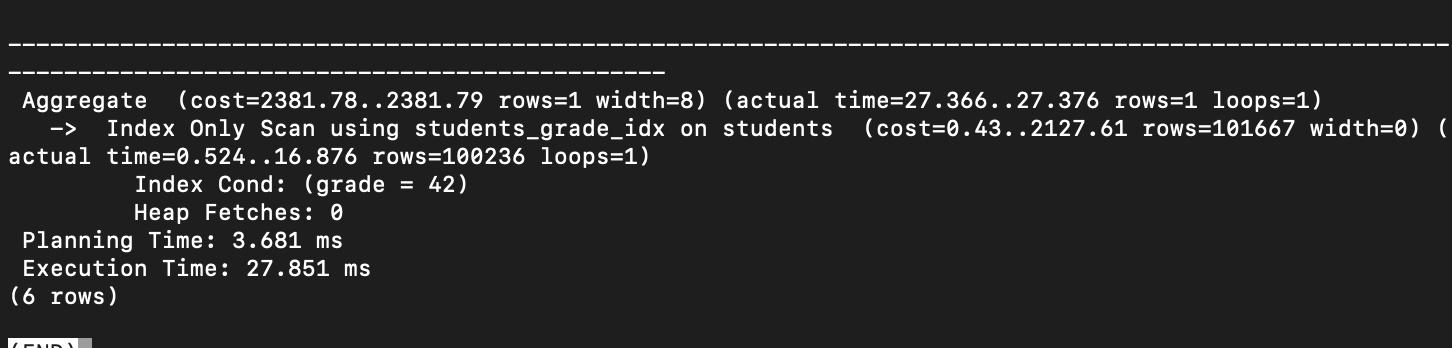
EXPLAIN ANALYZE SELECT COUNT(*) FROM students WHERE grade BETWEEN 42 AND 45 ;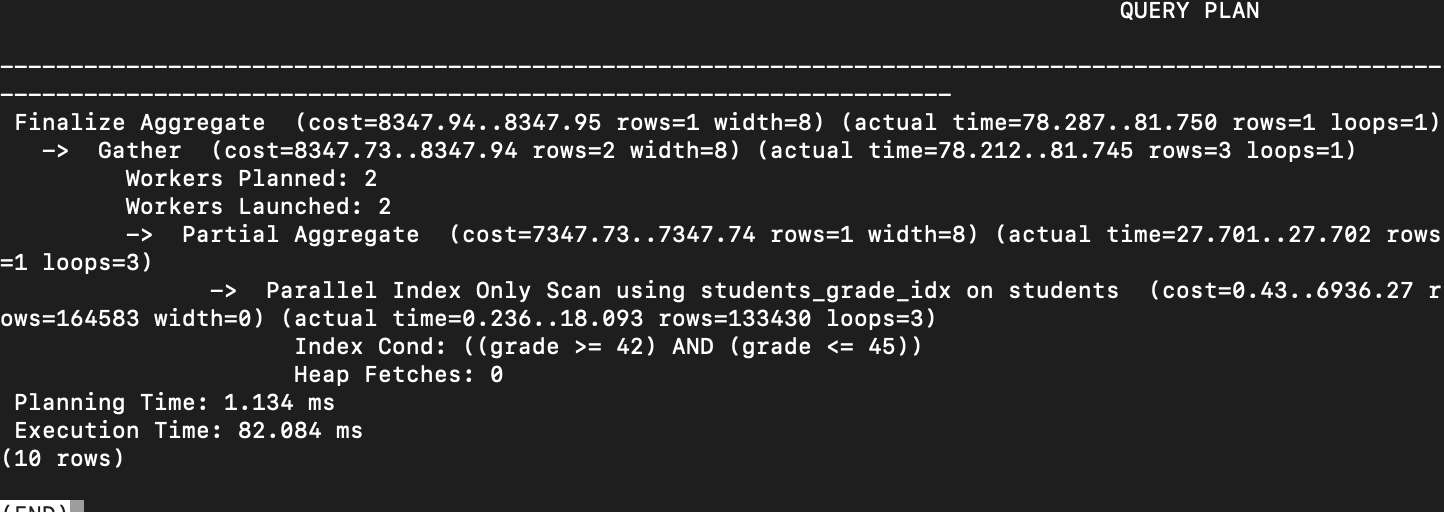
Endi partition uchun jadval yaratamiz (ushbu buyruqdan foydalanamiz).
CREATE TABLE students_parts (
  id INT NOT NULL,
  name TEXT NOT NULL,
  grade INT NOT NULL,
  PRIMARY KEY (id, grade)
) PARTITION BY RANGE (grade);
Nega primary keyga gradeni qo'shdik . POSTGRESqlda primary key hamma partitionlar bo'yicha unique bo'lishi kerak.
Note:Partition key null bo'lmasligi kerak.
Endi jadval uchun barcha partitionlarni birma bir kiritib chiqamiz.
CREATE TABLE students_part_0_40 PARTITION OF students_parts
  FOR VALUES FROM (0) TO (40);
CREATE TABLE students_part_40_70 PARTITION OF students_parts
  FOR VALUES FROM (40) TO (70);
CREATE TABLE students_part_70_80 PARTITION OF students_parts
  FOR VALUES FROM (70) TO (80);
CREATE TABLE students_part_80_100 PARTITION OF students_parts
  FOR VALUES FROM (80) TO (100);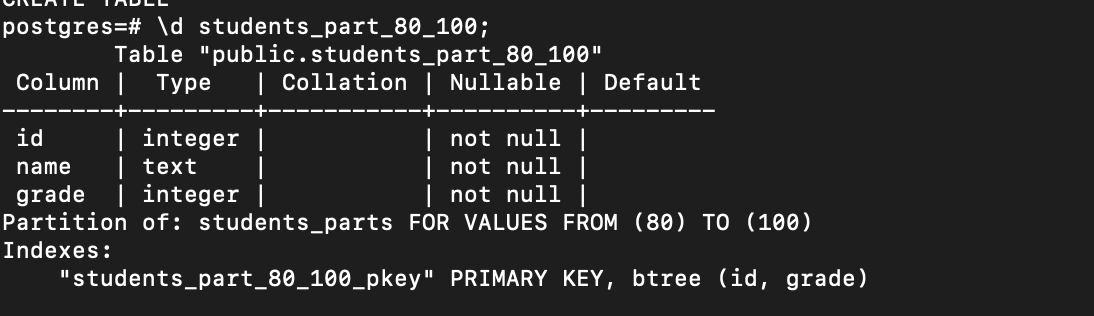
Endi oldingi tabledagi ma'lumotlarni insert qilamiz.
INSERT INTO students_parts SELECT * FROM students;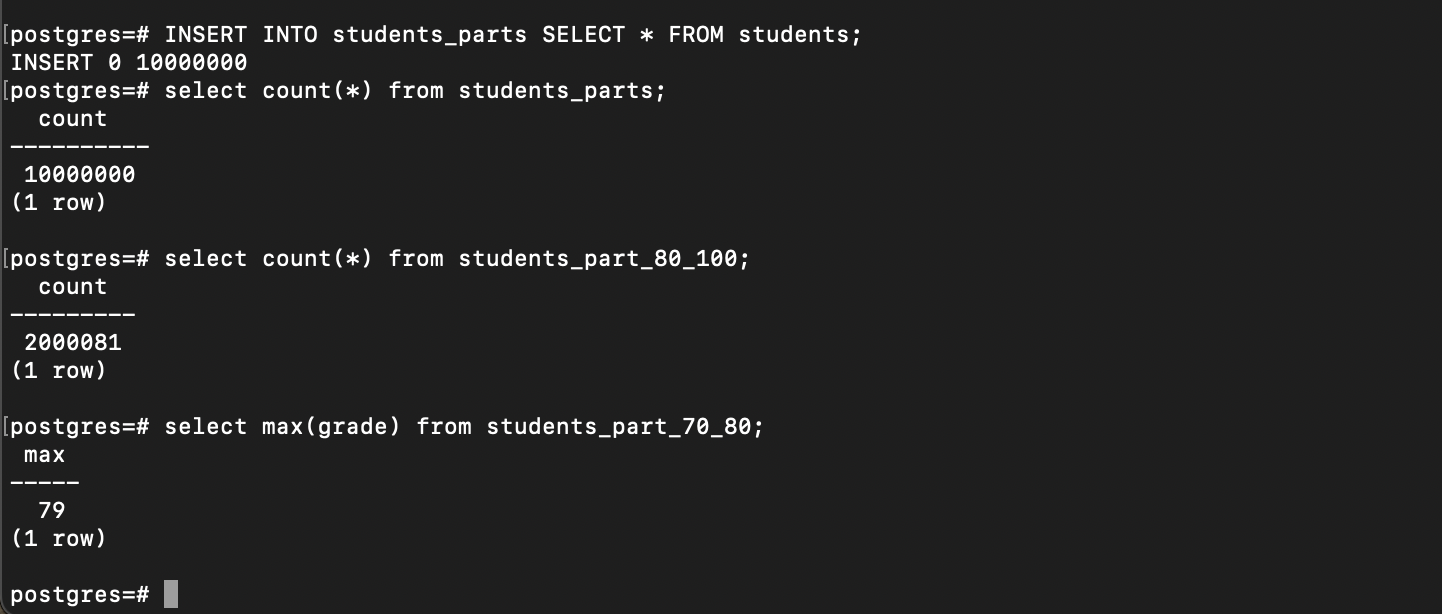
Ko'rib turganingizdek hamma ma'lumotlar biz bergan partition bo'yicha ajratildi.
Va yana bir yaxshi tomoni endi partition qilingan jadvalda yaratgan indexlar avtomatik tarzda har bir partitionga index bo'lib o'tadi.
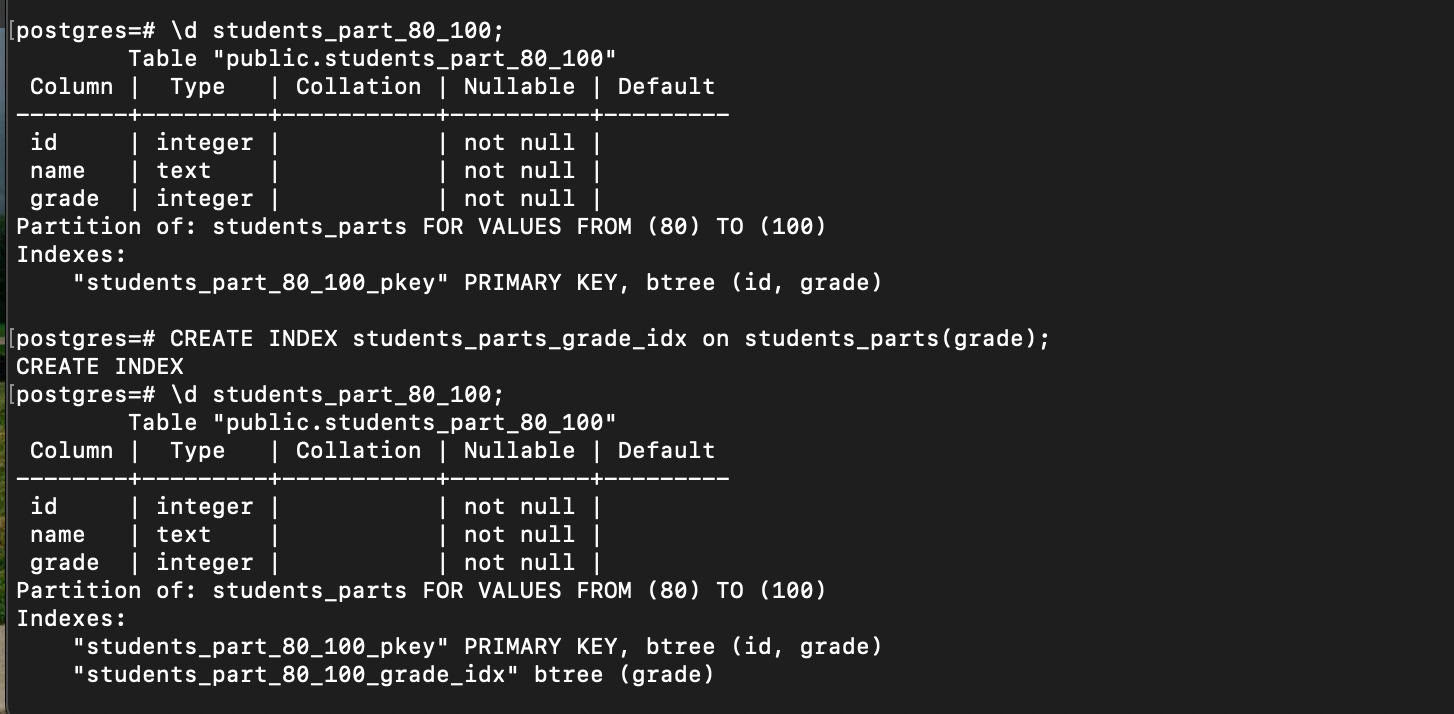
Endi Oldingi querylarni qayta qilib ko'ramiz.
EXPLAIN ANALYZE SELECT COUNT(*) FROM students_parts WHERE grade = 42;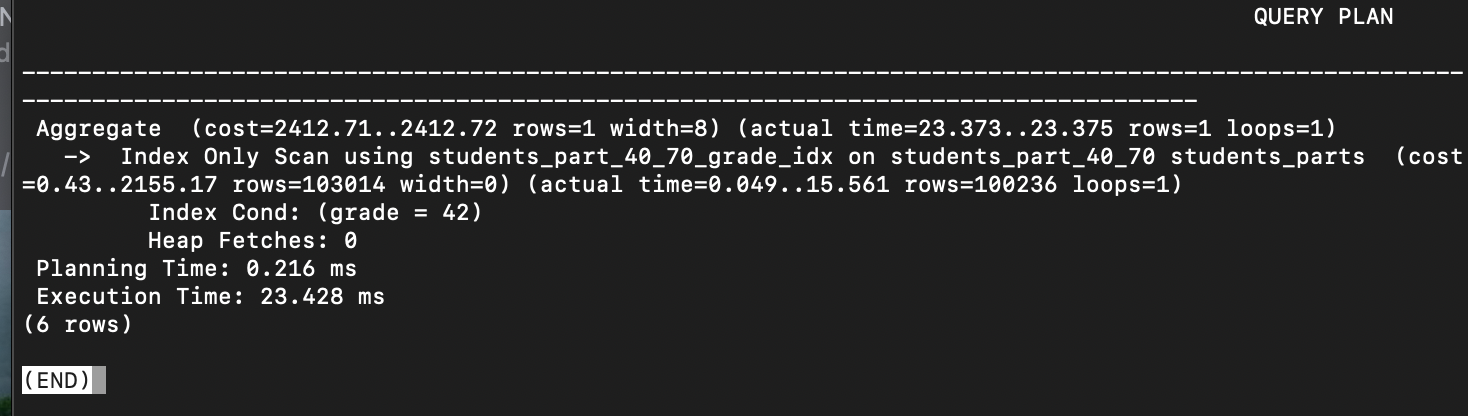
Ko'rib turganingizdek u faqatgina bir partitiondan foydalanmoqda.
Nega bu yerda unchalik tez emasku deyishingiz mumkin sababi men Docker orqali ishlatmoqdaman hamda unda xotira ishlatishda umuman limit yoq. Bu holat qachonki ma'lum xotiraga index sig'may qolganda vaqtlardagi farq juda kattalashib ketadi.
Note: Partition pruning databazada yoniq bo'lishini unutmang. command =>(show ENABLE_PARTITION_PRUNING;)
Note: Partition pruning databazada yoniqligini tekshiring as holda partitioning shunchaki havoga uchadi. Hamma partition skaner qilinadi. command =>(show ENABLE_PARTITION_PRUNING;)
Automation
Siz partitionlashni script yozish orqali avtomatlashtirish mumkin va tepadagi table uchun partitionlash kodni bu yerdan topishingiz mumkin.
Foyda va zararlari
Partitioning foyda va zararlari
Foydasi1. Faqatgina bitta partition bilan ishlaganda query tezligini oshiradi .
2.Planner ba'zan indexni skanerlash o'rniga seq scan tanlaydi , partitionlash orqali unga tanlash imkoniyatini osonlashtiramiz (kamroq o'qiymiz).
Oson bulk loading (Yangi partition qo'shish orqali)
Eski ma'lumotlarni (kam holatlarda ishlatilinadigan) arzon xotiraga o'tkazish.
Zarari1. Bir rowni bir partitiondan boshqa partitionga o'lib o'tishi kerak bo'lgan yangilanishlar juda sekin yoki bazan fail bo'ladi.
2.Noto'g'ri querylar hamma partitionlarni skanerlashni boshlashi mumkin va natijada query sekinlashadi .
Sxemani keyinchalik o'zgartirish qiyin bo'lishi mumkin.
Xulosa
Xulosa qilib aytadigan bo'lsak database partitioning katta miqdordagi ma'lumotlar bilan ishlaganda muhim ,chunki u bilan siz oldingi performanceni saqlab qolasiz hamda osongina scale qilishingiz mumkin, hamda ularni boshqarish ancha oson. Indexlar hajmi ham qisqaradi va faqatgina kerakli partitionlar o'qiladi.