Databaza ma'lumotlarni diskda qanday saqlaydi? Page, heap, index
Assalamu Alaykum bugun databazada jadvallar va indexlar diskda qanday saqlanishi, hamda ular query orqali qanday topilishini ko'rib chiqamiz.
Bugungi maqolamizadagi mavzular:
Jadval (Table)
Row_id
Page
I/O
Heap
Index
Queryga misollar.
Jadval (Table)
Jadval bu databazalardagi hamma ma’lumotlarni saqlaydigan bit struktura va unda qator(row) va ustundan (column) iborat.
Row_id (Unique identifier)
Odatda databazalar biz bergan fieldlar bilan to'liq ishlamaydi (ba’zilari ishlaydi) , ular o'zlarining boshqaradigan row yaratishadi bu postgresdda tuple_id deb ataladi . Biz o'sharow qiymatlarini oddiy qilib row\_id deymiz. Row_id bu databaza jadvallardagi qatorlarni ajratib olish uchun ishlatadigan unique identifier. MySQLda primary key o'sha row_id bo'ladi va primary key row xuddi o'sha row vazifasini bajarib beradi.
Key mavzusi haqida ko'proq ma’lumot olish uchun ushbu maqolani o'qing. Databasedagi keylari !!
Page
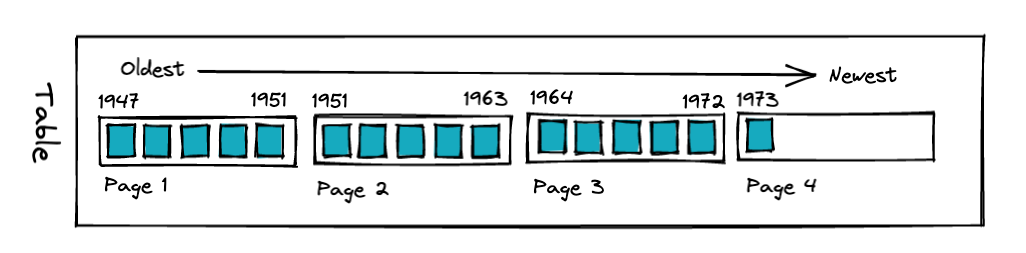
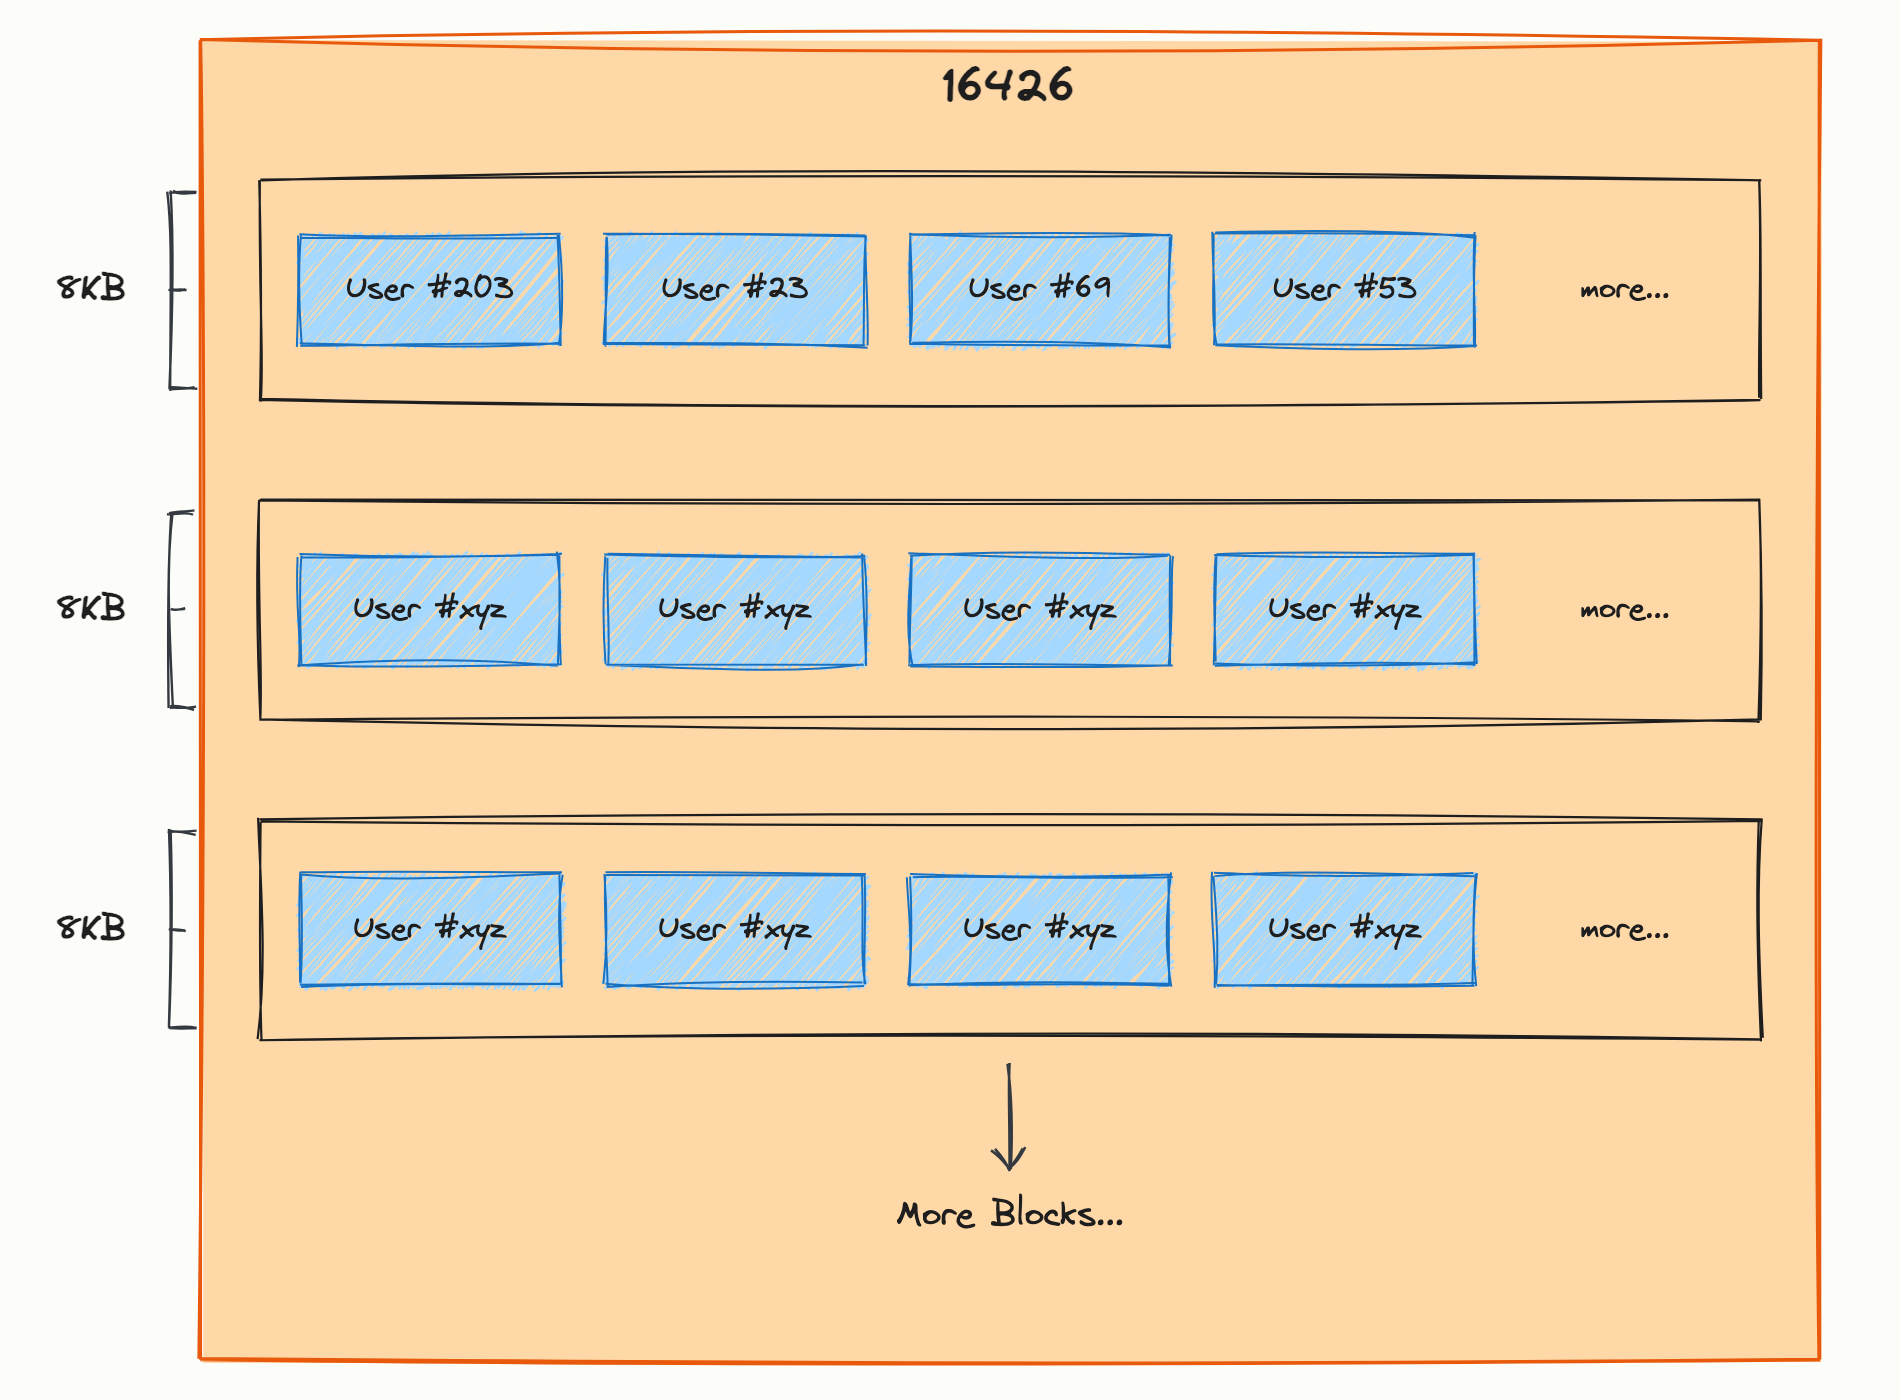
Page bu databazadagi rowlar saqlanadigan xotira bloki, u databaza turiga (row or column based) qarab har xil bo'ladi . Databazadagi hamma ma’lumotlar pagelarda saqlanadi.Ular odatda bir xil hajmdagi xotira bloki bo'ladi (8KB postgres, 16KB mysql ) hamda ular bir yoki bir necha row saqlashi mumkin (row hajmiga bog'liq) va ularni hajmini buni o'zgartirish mumkin. Shuning uchun biz qachonki I/O orqali ma'lumot o'qisak ,biz pageni o'qiymiz bittagina rowni emas , unda bir necha row bo'ladi. Tushunishingiz oson bo'lishi uchun tassavur qiling sizda 100 rodan iborat jadval bor va bitta page 3 ta rowni saqlay oladi va bu bizga 33–34 ta pagega bo'lingan holda diskda saqlanadi . Bu queryining tez yoki sekin bo'lishiga ta'sir qiladi (siz qancha ko'p page o'qisangiz , shuncha I/O ko'p bo'lishi mumkin).
I/O
I/O bu diskdan ma’lumot o'qish berilgan operatsiya . Biz buni iloji boricha kamaytirishga harakat qilamiz sababi kam I/O queryni tezlashtiradi .I/O orqali biz orqali biz bir yoki bir necha page o'qiy olamiz ,bitta rowni emas ! Bu shunchaki bir nechta rowlik page xolos , shuning uchun SELECT name bizga qimmatga tushadi chunki biz allaqachon hamma ma'lumotni diskdan o'qib bo'ldik . Disk ma’lumotni deserialize qiladi va keraksiz infoni olib tashlaydi). Ba’zi I/O operatsiyalari OS cachega boradi to'g'ridan to'g'ri diskga emas (ko'pincha postgresda optimizatsiyalar uchun).
Agar pagelar ketma ket joylashgan bo'lsa biz bir I/O orqali bir necha pageni o'qishimiz mumkin.
Heap
Heap bu logical pagelar(physical emas) kolleksiyasi , va ular har bir pageni xotirasiga pointer ushlab turadi . Jadvaldagi hamma narsa heapda bo'ladi va bu query qilishni qiyinlashtiradi aynan shuning uchun bizga indexlar kerak bo'ladi chunki ular bizga heapning aynan qaysi qismini o'qish kerakligini ko'rsatadi.
Note !!! Heap bu yerda Heap data strukturasi emas!!!
Index
Index bu o'sha mashhur queryni tezlashtiradigan databazadagi bir yo'l . Bu qanday ishlashini ko'rib chiqamiz. Index asosan (B Tree) data strukturasidan foydalangan holda bizga kerakli bo'lgan ma’lumotni heapdagi pointerini (row\_id) beradi.U ba’zi ma’lumotlarni tezda topish o'zida saqlaydi bu siz indexlagan bir yoki bir necha column bo'lishi mumkin . Siz indexdan o'zingizga kerakli bo'lgan ma’lumotni topganda , heap pointer orqali heapga borib va kerakli hamma ma’lumotni olishi mumkin.Index bizga aynan qaysi pageni o'qish kerakligini aytadi va biz bu orqali heapni scan qilmasdan aniq kerakli ma’lumotni topa olamiz. Indexlar ham pagelarda saqlanadi va indexni o'qish ham bir necha I/O ga sabab bo'ladi . Shuning uchun kichkina hajmdagi index tez ishlaydi chunki ularni memory olib olish oson va kam joy oladi.
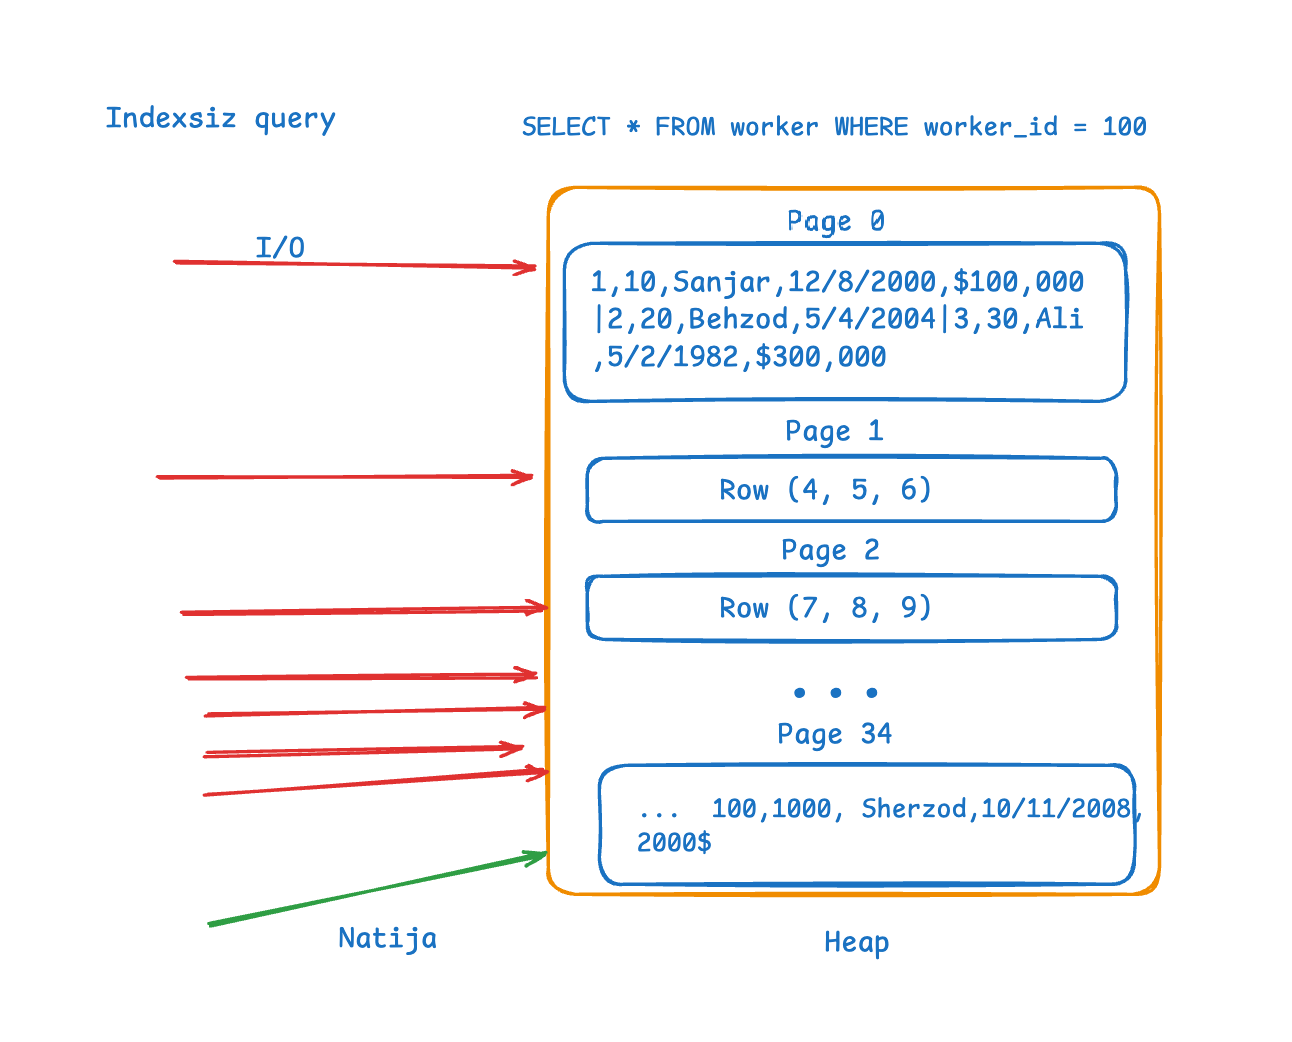
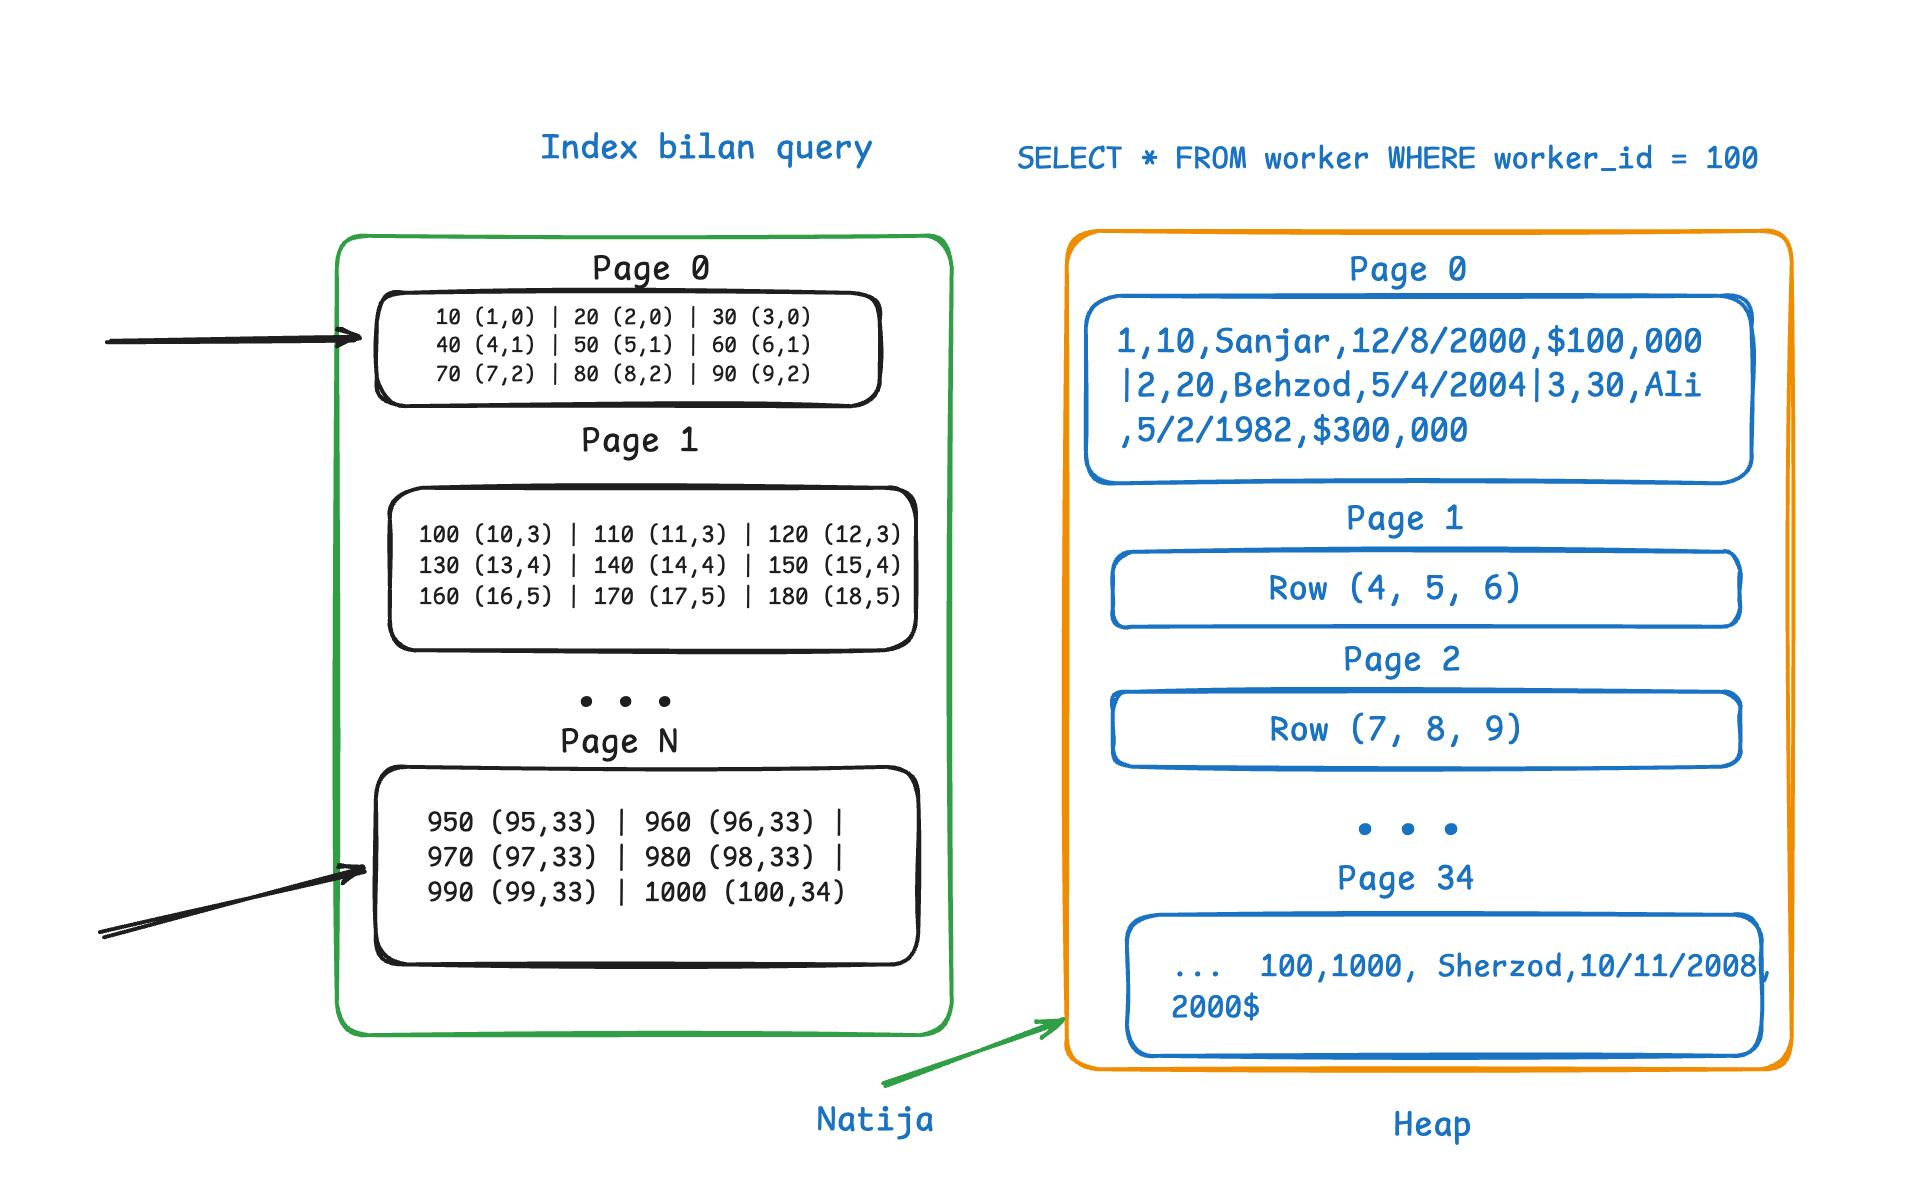
Tepada ko'ringanidek index bilan kam I/O ishlatilinadi.(Rasmlar tushuntirish uchun bunaqa chizildi va bu databazadagi ma’lumotlarni to'liq shunaqa deb tasvirlamaydi).
Ba’zi databazalar index bo'lmaganda queryini tezlashtirish uchun multi threaddan foydalangan holda tepa va pastdan scan qilishni boshlashadi. Ba’zan heapni bir qismi shared buffer xotirada bo'ladi queryini tezlashtirish uchun .
Tartiblashgan Heap
Odatda Heap tartiblanmagan bo'ladi ammo ba’zi holatlarda u bir indexga asoslangan holda tratiblangan bo'ladi va bu index clustred index deyiladi yoki IOT (index Organized table) deb ham atalishi mumkin(Oracle) .Primary key odatda clustred indx bo'ladi boshqasi berilmaguncha. MySQL va InnoDBda har doim clustred index (primary key) bo'ladi va qolgan indexlar shu primary key qiymatiga yo'naltiriladi.Ammo postgresda faqatgina secondary index bo'ladi va hamma indexlar heapda joylashgan row_idga yo'naltiriladi.
Shuning uchun qaysi turdagi fieldni index uchun tanlashda ehtiyot bo'ling .Masalan random uuid index sifatida clustrer index bo'lsa heap random holatda tartiblangan bo'ladi va bu siz ma’lumotni olishingizda bir necha pageni o'qishingizga to'g'ri kelishi mumkin va bu ma’lumot yozayotganda hamperformanceni tushuradi.
Sizga kelishi mumkin bo'lgan savol bir nechtasiga javob yozib ketaman. Agar sizda birortasi bo'lsa commentda yozishingiz mumkin.
Row 2 ta yoki bir nechta pageda saqlanishi mumkinmi ?
Ha, odatda databazalar fixed hajmli ma’lumotlarni shu pageda saqlab , string va blob typedagi ma’lumotlarni boshqa table ochib unda saqlashadi va bizdagi pageda o'sha yerga pointer turadi. Yoki row shunchalik kaata bo'lib ketsa u keyingi pagega o'tishi mumkin bu holatda oldingi page hali ma’lumot tugamaganligi va keyingi pageda borligi haqida ma’lumot saqlab qo'yadi .
Agarda Posgtres row_id ishlatilsa nega har updateda indexlar o'zgaradi ?
Har doim Postgres ma’lumot o'zgarganda u yangi versiya yaratadi va row_id dead ya’ni ishlatilmaydigan deb belgilaydi .Bu updateda yangi row_id yaratilib o'shanga ma’lumotlar ulanadi, o'chirishda esa row_id shuncaki dead deb beligilanadi va Vacuum uni to'zalash paytida o'chirib yuboradi.
Xulosa
Xulosa qilib aytadigan bo'lsak pages bu shunchaki fayllar va databaza bizni malumotlarni shu page fayllarda saqlab kerak bo'lganda OS filesystem orqali ularni bizga o'qib beradi. Heap esa o'sha pagelarga pointer sifatida turadi. Index esa bizga heapning aynan qaysi qismini o'qib o'sha pageda ma’lumot olishimizga yordam beradi .