Databazada index nima? EXPLAIN va index scan to'liq qo'llanma
Assalamu Alaykum bugun datazabazadagi index bizga qanday yordam berishi , databaza optimizier uni nimaga asoslab tanlashi va qaysi indexlar qaysi holatda foydali ekanligi haqida bafurcha gaplashamiz.
Index
Index bu tartiblangan data strukturasi bo'lib u jadvaldagi qaysidir column bo'yicha tartiblangan bo'ladi jadval haqida bir qancha ma’lumotni saqlaydi (to'liq emas) va bizga o'zimizga kerakli bo'lgan ma'lumotni tezroq topishimizga yordam beradi (aniq qaysi pagelarni o'qishni aytish orqali).
Index 2xil turda bo'ladi B-tree va LSM tree. Bular haqida keyingi maqolalarda gaplashamiz.
Ushbu millon qatorlik ma’lumot yaratadigan scriptni test qilish uchun foydalanishingiz mumkin.
Postgres databazasini dockerda ko'tarish uchun buyruq :
docker run --name index-test -p 20000:5432 -d -e POSTGRES_PASSWORD=postgres postgres:latest
docker exec -it index-test psql -U postgres //postgresga kirish uchun
const { Client } = require("pg");
const { faker } = require("@faker-js/faker");
const client = new Client({
user: "postgres",
host: "localhost",
database: "postgres",
password: "postgres",
port: 20000,
});
async function seed() {
try {
await client.connect();
await client.query(`
CREATE TABLE IF NOT EXISTS people (
id SERIAL PRIMARY KEY,
name TEXT NOT NULL
);
`);
console.log("Table is ready.");
const BATCH_SIZE = 1000;
const TOTAL = 1_000_000;
for (let i = 0; i < TOTAL; i += BATCH_SIZE) {
const values = [];
for (let j = 0; j < BATCH_SIZE && i + j < TOTAL; j++) {
const fullName = faker.person.fullName();
values.push(`('${fullName.replace(/'/g, "''")}')`);
}
const query = `
INSERT INTO people (name)
VALUES ${values.join(",")};
`;
await client.query(query);
console.log(`
Inserted ${i + values.length} / ${TOTAL}`);
}
console.log("Done seeding 1 million rows!");
} catch (err) {
console.error("Error:", err);
} finally {
await client.end();
}
}
seed();\d table name orqali siz table haqida ma’lumotlar olishingiz mumkin .
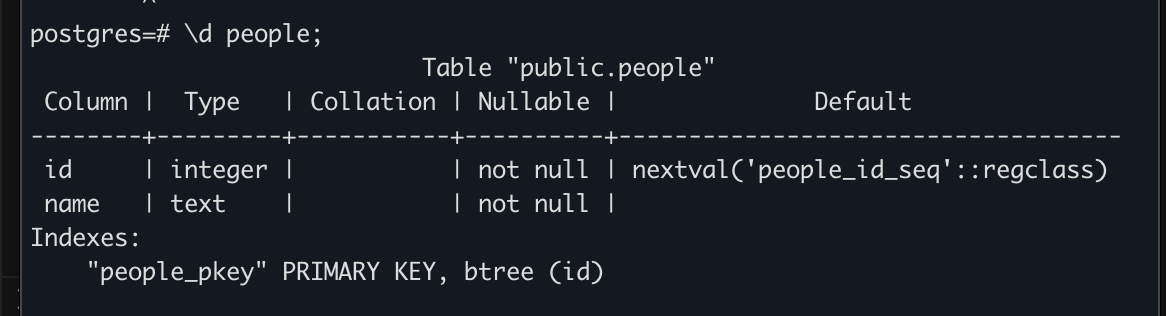
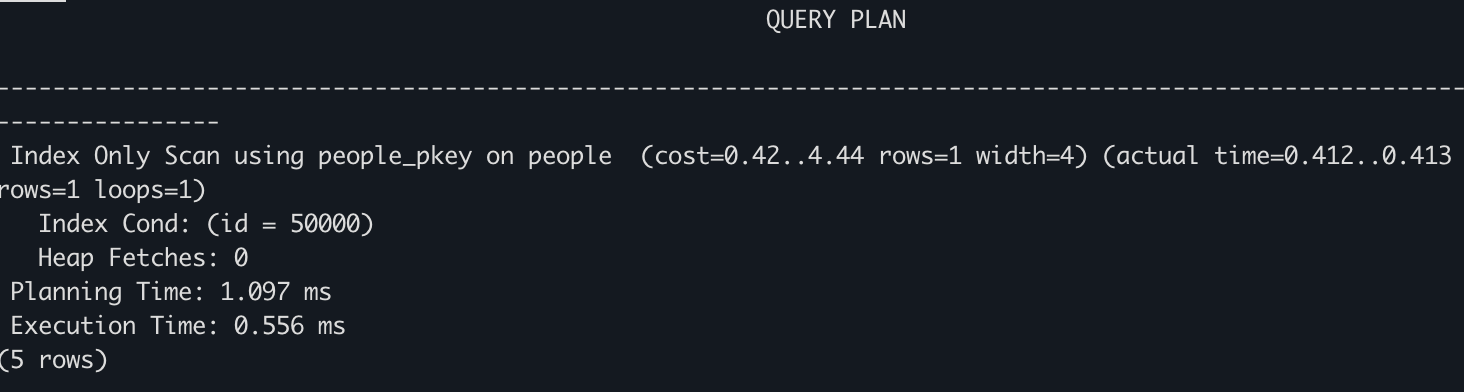
Hozir yaratilgan databazadan foydalanib bir necha querylar qilib ko'ramiz va ularni performancelarini ko'rib chiqamiz. Bu yerda explain analyze qo'shib ishlatamiz bunda u bizga natijani emas shuni olish uchun qaysi usuldan foydalanigani va boshqa ma'lumotlarni chiqarib beradi.
1-query
SELECT id FROM people WHERE id = 50000
2-query
SELECT name FROM people WHERE id = 300000
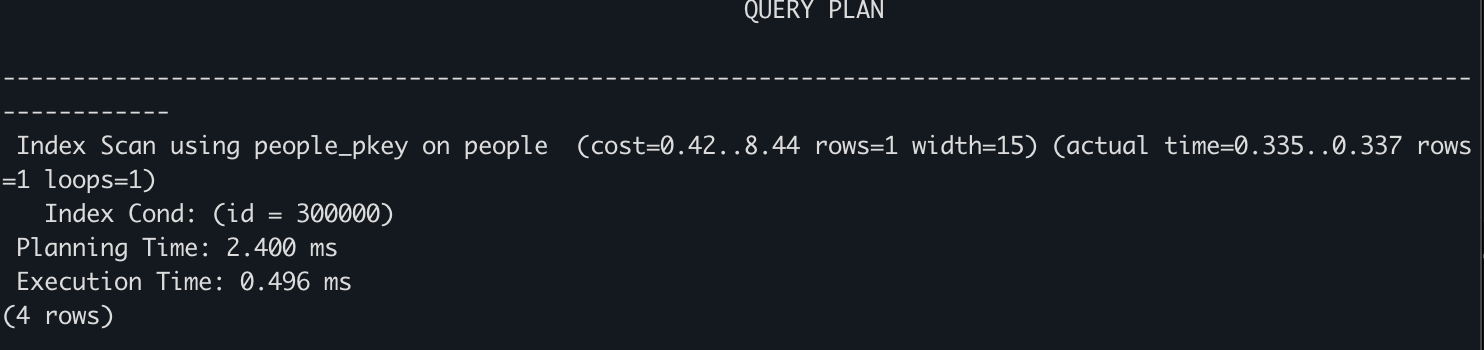
Bu holatda idni index orqali topgandan so'ng heapga o'tib nameni oladi .
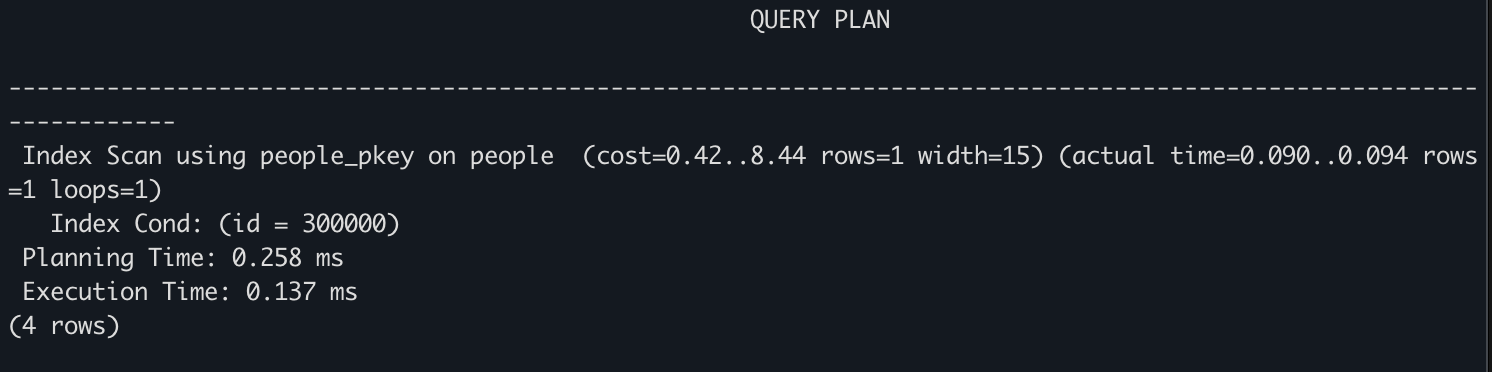
Agarda shu queryni 2-marta ketma-ket run qilsak bu tezrow ishlaydi chunki postgres querylarni tezlashtirish uchun ularni cache laydi .
3-query
SELECT id FROM people WHERE name = ‘Anna Grant’
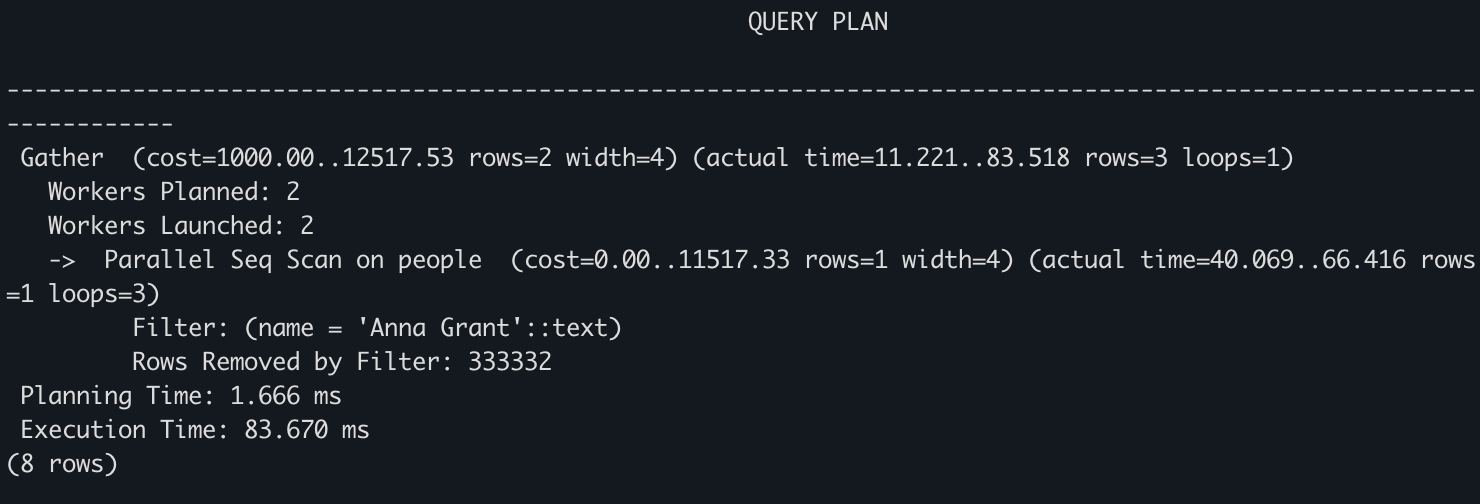
Loglardan ko'rib turganingizdek planner sequential ya’ni hamma rowni skanerlab chiqmoqda va yaxshiroq performance(tezlashtirish) uchun worker threadlar ishlatilmoqda.
4-query
SELECT id FROM people WHERE name like ‘%Ha%’
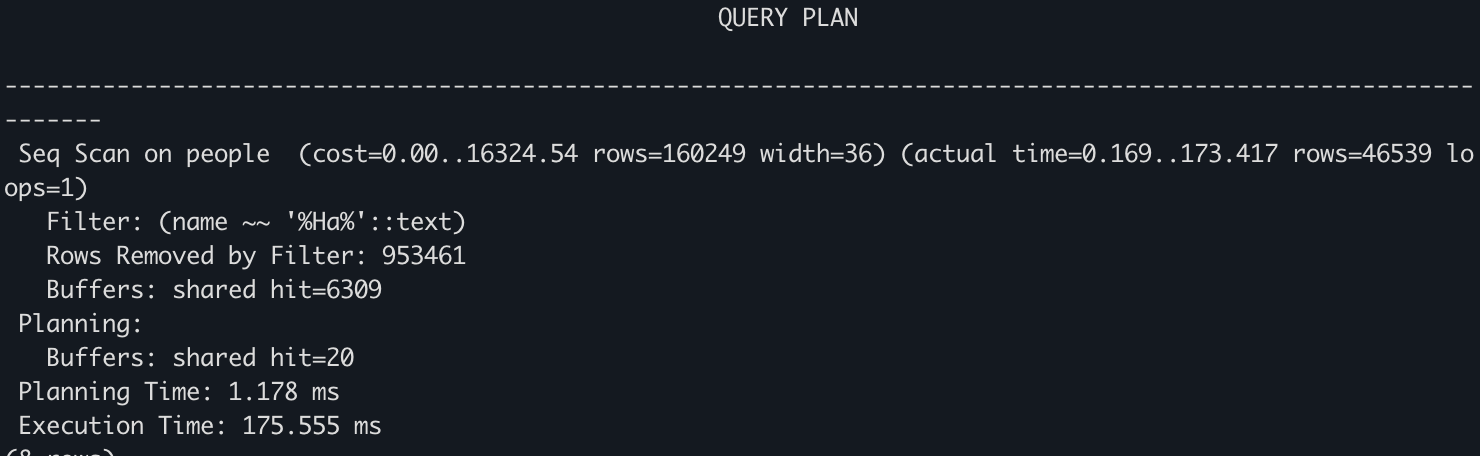
Bu eng yomon query buni rasmdagi natijalardan ham ko'rishingiz mumkin.
Buni tezlashtirish uchun keling name uchun ham index yaratamiz.
CREATE INDEX people_name on people(name);Va ushbu querylarni qayta run qilib ko'ramiz SELECT id, name FROM people WHERE name = ‘Anna Grant’
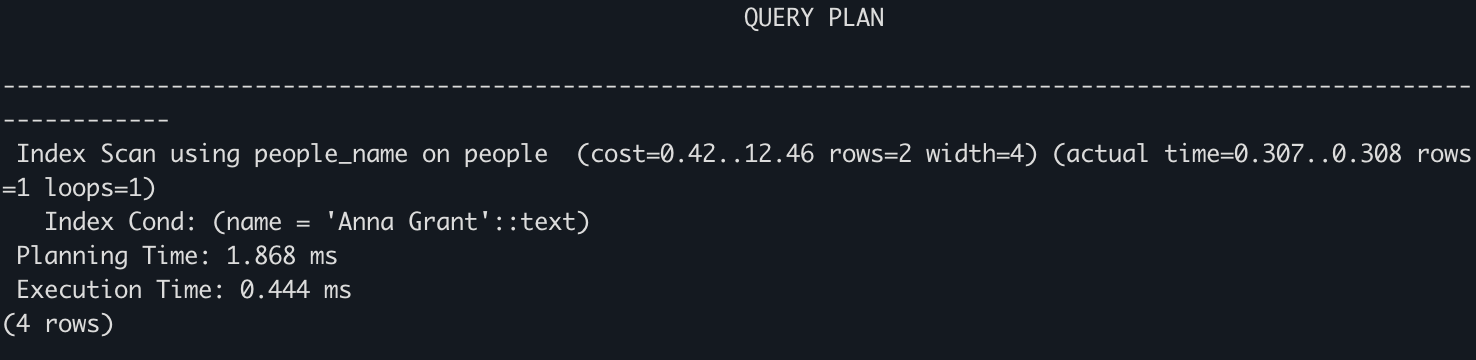
Bu hozir juda tez chunki biz yaratgan yangi indexdan foydalandi . Planner databazadagi ma'lumotlarga qarab bitmap index scan ham ishlatishi mumkin.
endi keyingi queryni ham tekshiramiz.SELECT id FROM people WHERE name like ‘%Ha%’
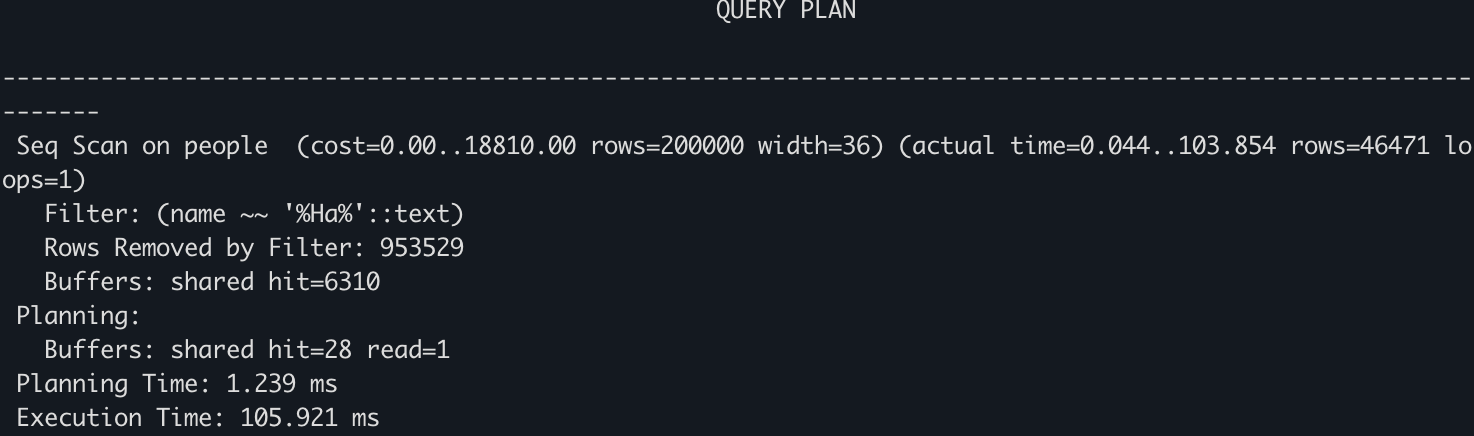
Bu query hailyam sekin chunki u haliyam sequential skanerlashni ishlatmoqda . Bu yerda biz name uchun yaratgan indexni ishlatolmaymiz chunki u shunchaki qiymat emas u expression (%Ha%)va bu indexni ishlatishimizga halaqit beradi natijada query sekinlashadi.
Note:Siz compound index qilganingizda qiymatlarni (indexlash uchun berilgan) indexda saqlaysiz va siz diskga bormasdan to'g'ridan to'g'ri nameni qaytarishingiz mumkin.
Explain kalit so'zi nimaga kerak ?
Postgresdagi explain kalit so'zi bu biz ushbu queryni amalga oshirayotganda qaysi plan bo'yicha borishimizni ko'rsatib beradi.
Tepadagi jadvalga misollarni ko'paytirish uchun grade column qo'shamiz.
const { Client } = require("pg");
const client = new Client({
  user: "postgres",
  host: "localhost",
  database: "postgres",
  password: "postgres",
  port: 20000,
});
async function addGradeColumnAndFill() {
  try {
    await client.connect();
    await client.query(`
 DO $$
 BEGIN
 IF NOT EXISTS (
 SELECT 1 FROM information_schema.columns
 WHERE table_name='people' AND column_name='grade'
 ) THEN
 ALTER TABLE people ADD COLUMN grade INTEGER;
 END IF;
 END
 $$;
 `);
    await client.query(`
 UPDATE people
 SET grade = FLOOR(RANDOM() * 100 + 1);
 `);
    console.log("✅ Grade column added and populated successfully!");
  } catch (err) {
    console.error("❌ Error:", err);
  } finally {
    await client.end();
  }
}
addGradeColumnAndFill();
SELECT * FROM people;
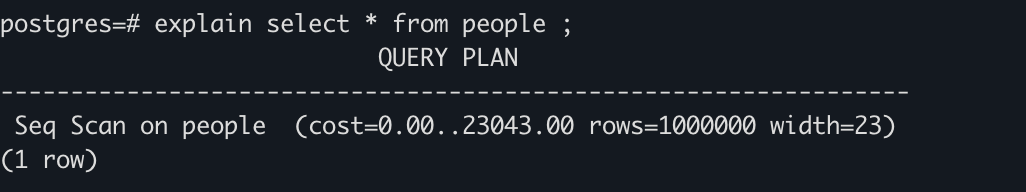
Tepadagi rasmda siz 2 ta raqamni ko'rishingiz mumkin cost degan qismda 2 nuqtadan oldingi son 1-chi pageni olishga ketgan vaqtni ko'rsatadi bu biz aggregate funksiyalarini ishlatganimizda o'sishini ko'rishimiz mumkin masalan order byda agar bu ko'tarilsa demak biz pagelarni o'qishdan oldin nimadir qilyapmiz. 2-chi raqam esa full queryni tugatish uchun kutilgan vaqt (bu haqiqatda shuncha bo'lmasligi mumkin taxminan) . rowsdagi raqam ham taxminan bo'ladi ammo haqiqiy qiymatga yaqin (tepadagi rasmda to'g'ri ) bo'ladi , width ham.
SELECT * FROM people ORDER BY grade;
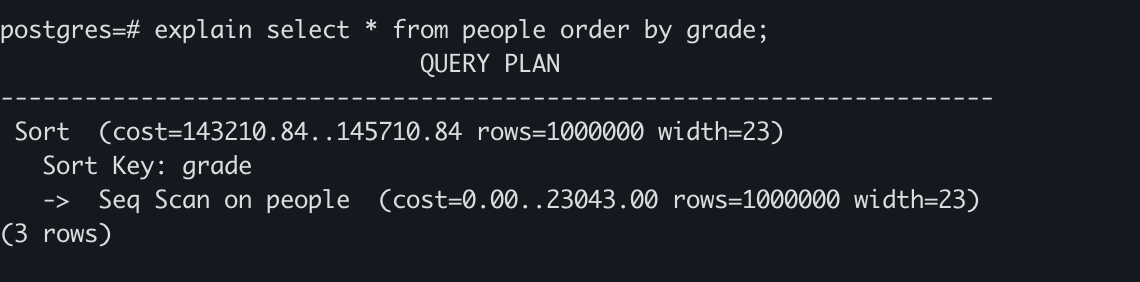
Tepadagi rasmda start vaqti o'zgarganini ko'rish mumkin order by borligi uchun .
SELECT * FROM people ORDER BY name;
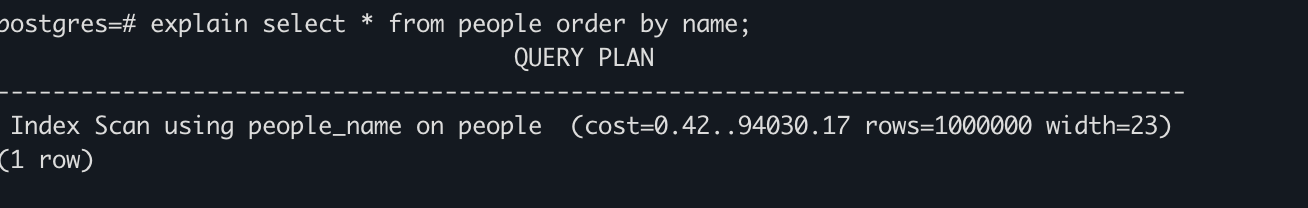
Tepada bizda name indexlanganligi uchun shu indexdan skanerlash uchun foydalandi va start vaqti ancha kamayadi .
SELECT id FROM people;
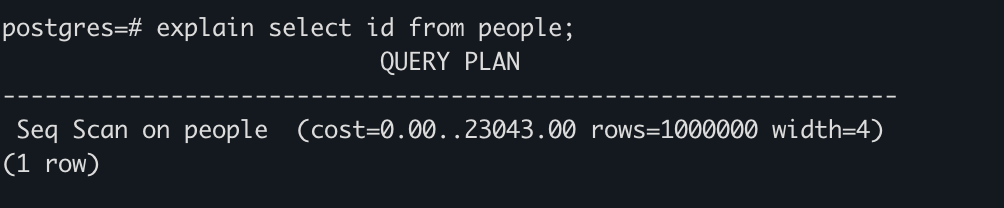
Tepadagi rasmda width o'zgarganini ko'rishimiz mumkin chunki id integer va u faqatgina 4 byte bo'ladi .
SELECT * FROM people WHERE id = 200;
Bu holatda biz index skanerlaymiz va kerakli pageni topib undan ma'lumotlarni o'qib uzatamiz. Index ko'pincha filterlash uchun ishlatiladi selectda esa pagedan o'qib ma'lumot beriladi.
Note : Cost bu yerda ms emas ammo katta raqamlar ko'p vaqt olishini bildiradi.
Index scan
Bizda 3 xil tirdagi skanerlash bor:
Squential scan
Index scan
bitmap scan
Bu yerda explain so'zidan foydalanib bularni farqini ko'ramiz.
Xo'sh postgres nimadan foydalanishni qanday tanlaydi , u jadval haqidagi taxminiy ma’lumotlarni (nechta row borligi va boshqalar) bilib shunga asoslangan holda o'zi uchun reja tanlaydi. Masalan agarda siz qidiradigan rowlar soni ko'p bo'lsa u indexni skanerlamasdan to'g'ridan to'g'ri heapga borib u yerdan birma bir rowlarni tekshiradi (sequential scan). Postgres planner bu yerda indexni tekshirish arzimaydi deydi va jadvalni to'liq skanerlaydi .Agarda u index skanerlash bizni juda kam rowga olib borsa u 1-chi index skanerlab so'ngra heap kerakli ma'lumotlarni olish uchun boradi (index scan) . MasalanSELECT name WHERE grade > 85bizdagi million qatorlik jadvalda bu ma'lumot ko'p ammo indexni skanerlash orqali ular sonini ancha kamaytirishimiz mumkin va bu holatda index skanerlanadi.
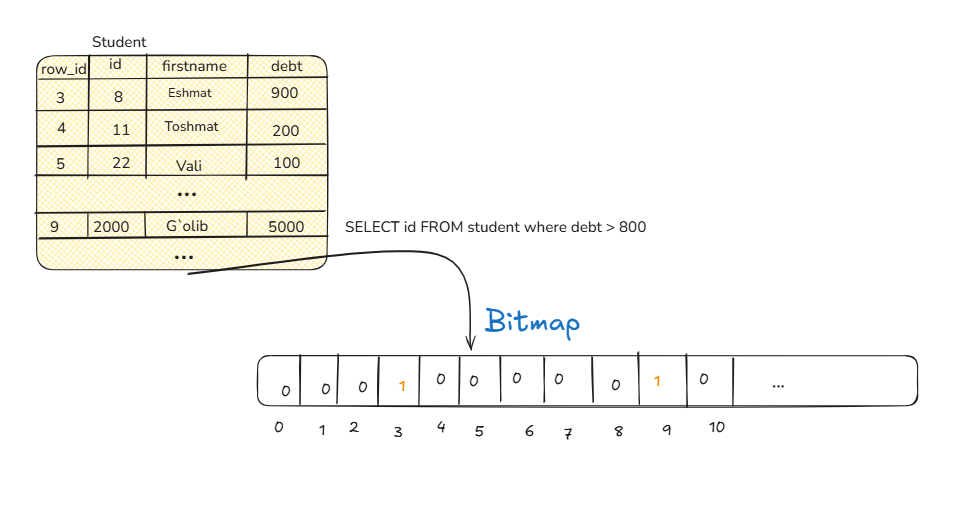
Tepada sequential va index scanni ko'rib chiqdik .Ammo bizda bitmap scan ham bor va bu ham performaceni ko'tarishga yordam beradi. Bizda tepadagi jadvalda grade columnda index bo'lsa , u shu indexdan foydalangan holda bitmap yaratadi yani shu gradedan baland bo'lgan pagelarga 0dan 1 ga o'zgartiradi va oxirida shu bitmapdan foydalangan holda qaysi pagelarni o'qish kerakligin bilib oladi va ularni o'qiganda yana qayta tekshiradi chunki bitta pageda bir necha row bo'ladi.
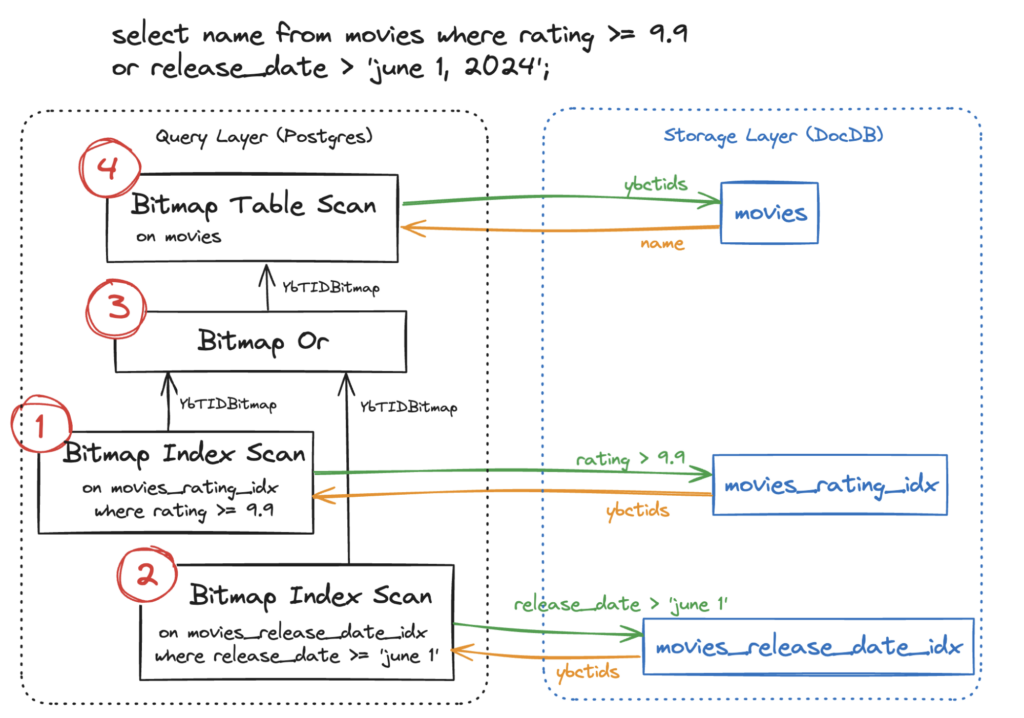
Bitmapning eng qulay tomoni siz bitta bitmapni ketma-ket 2 ta index uchun ham qo'llab keyin heapga o'tishingiz mumkin.
Key va Non-key column index
Key column index bu shu jadvalda shu column bo'yicha index yaratishni xohlaymiz va bu biz xohlagan hamma narsa . Non-key column index bu biz qaysidir column bo'yicha indexlaymiz ammo biz odatda boshqa column ma'lumoti kerak bo'ladi va uni ham shu indexga qo'shib qo'yish orqali heapga bormasligimiz mumkin . Masalan quyidagi jadvalda id orqali index qilin unga grade column non-key column index sifatida beramiz , chunki bizga odatda bu jadvaldan grade column kerak bo'ladi. Keling buni non-key index qo'shilgan va qo'shilmagan jadvalda performance orqali tekshirib ko'ramiz.
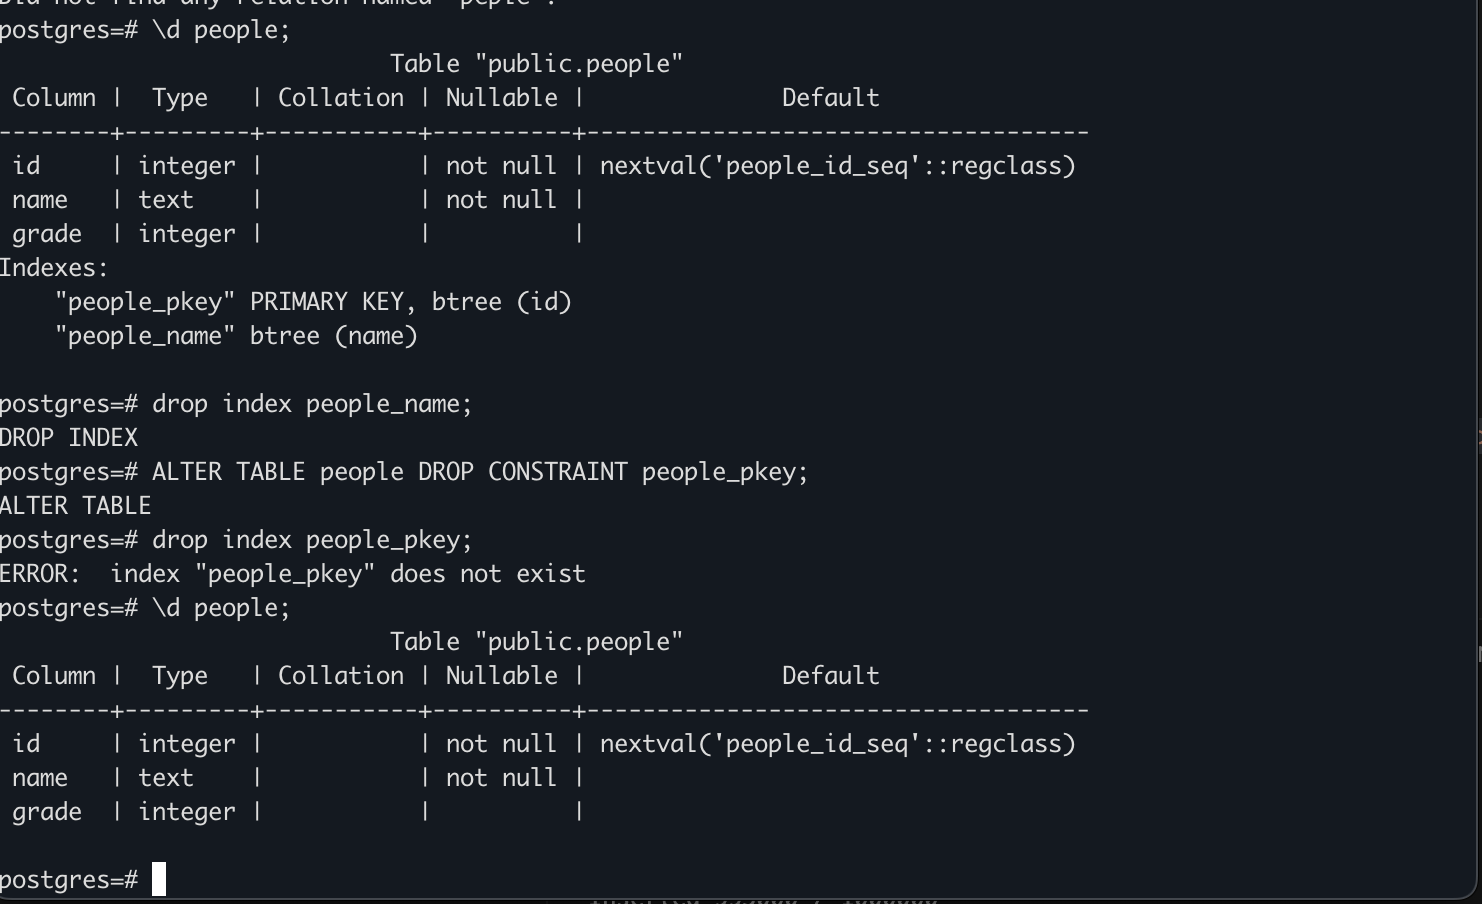
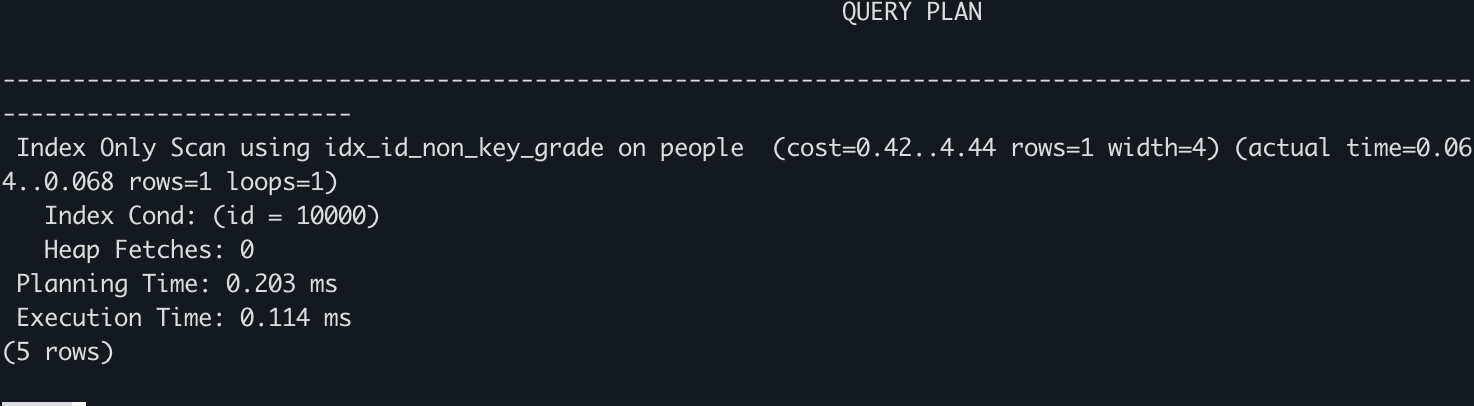
Non key column index performanceni ko'rsatish uchun people jadvalidan hamm indexlarni o'chirdim. Va_idning o'zida va id hamda grade non-key_column sifatida index yaratib performancelarni solishtiramiz.
SELECT grade FROM people WHERE id = 8000;
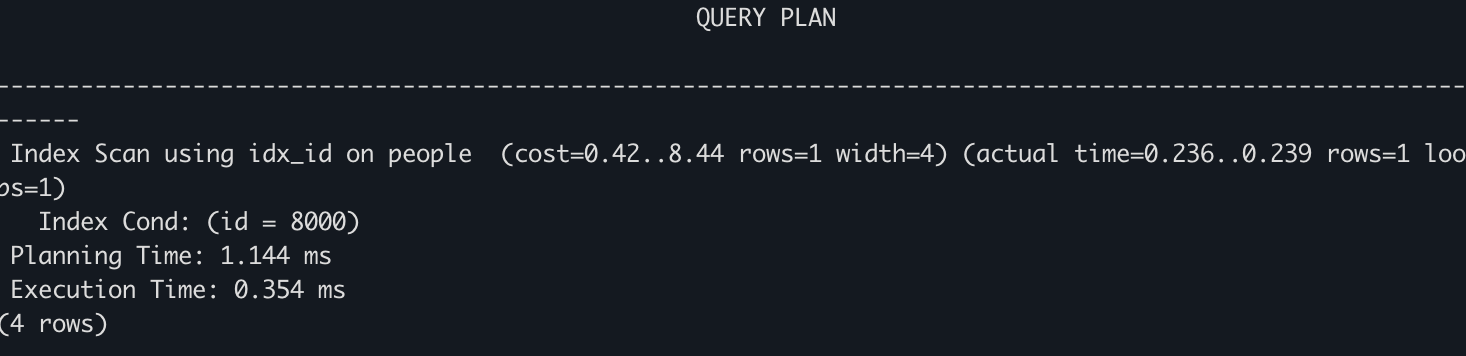
index
non-key index
ko'rib turganingizdek non-keyda index only scan ishlatilgan va u heapga bormasdan natijani qaytaradi va tezroq ishlaydi.
non-key column index yaratish:
CREATE INDEX idx_id_non_key_grade ON people(id) INCLUDE (grade);Index scan va index only scan
Index scan bu siz indexni tekshirib chiqasiz va to'liq ma'lumotni olish uchun heapga murojaat qilasiz , agarda biz so'ragan ma'lumot allaqachon indexning o'zida bo'lsa buni index only scan orqali yani faqatgina indexni o'zi tekshirib hamma m'lumot undan olinadi va bu performanceni ko'taradi .
Bundan tashqari bizda compound index ham bor bu 2 columnni birgalikda indexlash bu ham performance ko'tarishga yordam beradi ammo faqatgina chap taraf bilan ishlatilinsa chunki tree chap taraf qiymatlari ustiga qurilgan bo'ladi .
CREATE TABLE test(
  a INT,
  b INT,
  c INT
);
CREATE INDEX idx_a_b ON test(a, b);
SELECT * FROM test WHERE a > 10 ;
SELECT * FROM test WHERE a > 10 AND b < 67;
SELECT * FROM test WHERE b > 10;
SELECT * FROM test WHERE a > 10 OR b > 33;
Tepadagi 4 ta queryning 2 tasida idxab filterlash uchun ishlatiladi ammo keyingi 2 tasida ishlatilmaydi chunki b chap traf emas va indexdan filterlash uchun foydalana olmaydi .
Indexni concurrent yaratish
Productiondagi databazada index yaratish juda ko'p vaqt oladi hamda bu jadvaldagi o'zgartirish kiritishni bloklaydi , siz bemalol o'qiy olishingiz mumkin. Postgres bunga boshqa g'oya bilan kelgan yani ularni concurrent yaratish bunga ushbu buyruq orqali erishish mumkin :
CREATE INDEX CONCURRENTLY idx_grade on grades(grade)Bu buyruq ishlatilganda u hamma write transactionlar tugashini kutib keyin ishlashni boshlaydi . Ammo bu index yaratish kutishlar sababli ko'p vaqt olishi va fail bo'lishi mumkin yana agarda unique index uchun buyruq bersangiz u indexlangancha duplicate qiymat databazaga qo'shilib qolishi mumkin .
Xulosa
Xulosa qilib aytadigan bo'lsak databaza bizning querylarni tezlashtirish uchun har xil yo'llardan foydalanadi va juda ko'p narsalarni optimizatsiya qiladi ya’ni bitmap index , databaza planner nimadan foydalanishni rejalashtirish. Ammo u hamma qarorlarni o'zi qabul qiladi qaysi indexdan foydalanish fikrimcha buni o'zgartirish imkonini dasturchiga ham berish kerak .