Distributed system nima? Asosiy tushunchalar
Assalamu Alaykum , bugun distributed system nima ekanligini ko'rib chiqamiz . Distributed system bu bir necha qurilmalar biror bir vazifani bajarish uchun ma'lum bir kommunikatsiya usullari orqali ma'lumot almashib birgalikda ishlashiga aytiladi. Qurilma deganda sizning telefoningiz va balkim bir necha serverlarni nazarda tutishingiz mumkin.
Biz nega distributed system qurish haqida qayg`urishimiz kerak?
Bazi dasturiy mahsulotlar boshidanoq distributed system boladi .Masalan web bu siz bilgan distributed system bo'lib. Undan siz telefon, kompyuter va planshetlaringiz orqali dunyodagi barcha odamlar bilan birgalikda bog'lanib foydalanishingiz mumkin.
Yana boshqa sabablaridan biri bu ba'zi dasturlar high availability (serverlar doim javob berishini) va xatoliklarga chidamli (resilient) bo'lishini talab qiladi. Masalan Dropbox sizning malumotlaringizni bir nechta serverlarda nusxalarini saqlaydi va agar qaysidir serverdan malumotlaringiz o'chsa siz malumotlaringizni butunlay yo'qotishingizni oldini oladi.
Bundan tashqari bazi dasturiy ta'minotlar juda ko'p yuklama bilan ishlaydi . Bunga misol Google har soniyada millionlab so'rovlarni qabul qiladi buni faqat bir qurilma bilan qayta ishlashning imkoni yoq.
Bu maqolada siz distributed system qurish uchun kerak bo'ladigan boshlang'ich bilimlarni olasiz.
Aloqa (Communication)
Qurilmalar tarmoq(network) orqali bir birlari bilan ma'lumot almashish birinchi qiyinchilikni yuzaga keltirib chiqaradi.Masalan,siz websaytni brauzerda yuklamoqchi bolganda browser url orqali server addresini aniqlaydi va HTTP so'rov jo'natadi. Natijada server foydalanuvchi xohlagan malumotni javob sifatida beradi. Bunda bizda bir nechta savollar bor, masalan kabellar orqali so'rov va javoblar qanday boradi, agarda internet uzilishlari sababli malumotlar almashib ketsachi, bu aloqa o'rtasiga boshqa qurilma suqulib kira oladimi? Buni esa bazi kutubxonalar abstraksiyasi sababli bizga unchalik malum emas .
Bir qarorga kelish (Coordination)
Distributed systemni qurishning yana bir qiyinchiligi — nosozliklar mavjud bo’lganda joylarni yagona loyihaga muvofiqlashtirish va ishlashda davom etishi . Failure — bu ishlashni to’xtatgan qurilmalar , tizim bir yoki bir nechta nosozliklarga qaramay ishlashni davom ettira oladigan bo’lsa, nosozliklarga chidamligi yuqori bo'ladi. “Ikki general” muammosi — bu holatni judayam yaxshi tariflab beradigan mashhur muammo.
Faraz qilaylik, har biri o’z armiyasini boshqaradigan ikkita general (qurilma) bor, ular shaharga birgalikda hujum qilish vaqtini kelishib olishlari kerak. Qo’shinlar o’rtasida bir oz masofa bor va aloqa qilishning yagona yo’li — xabarchi (so'rov) yuborish. Afsuski, bu xabarchilar dushman tomonidan qo’lga olinishi mumkin (tarmoq ishlamay qolishi).
Generallar vaqtni kelishib olishlari mumkinmi? Xo’sh, 1-general 2-generalga taklif qilingan vaqt bilan xabar yuborishi va javobni kutishi mumkin. Agar javob kelmasa-chi? Xabarchilardan biri qo’lga olinganmi? Ehtimol, xabarchi jarohat olgan va manzilga yetib borish kutilganidan ko’proq vaqt talab qilayotgandir? General boshqa xabarchi yuborishi kerakmi?
Ko’rib turganingizdek, bu muammo dastlabki holatidan ancha qiyin. Ma’lum bo’lishicha, qancha xabarchilar yuborilmasin, hech bir general boshqa qo’shinning bir vaqtning o’zida shaharga hujum qilishiga to’liq ishonch hosil qila olmaydi. Ko’proq xabarchilar jo’natish generalning ishonchini oshirsa-da, hech qachon mutlaq ishonchga erisha olmaydi.
Shuning uchun muvofiqlashtirish juda muhim hisoblanadi.
Kengaya olish (Scalability)
Distributed systemning samaradorlik darajasi qanchalik yuklamani ko'tara olishiga qarab aniqlanadi va odatda u throughput va response time ga qarab hisoblanadi. Throughput bu bir sekundda nechta operatsiya bajarilishi, response time esa foydalanuvchi so'rov jo'natib javobni qabul qilguncha ketgan umumiy vaqt.
Yuklamalar har xil o'lchanishi mumkin bu dasturning talablariga qarab o'zgaradi.Masalan bir vaqtda nechta foydalanuvchiga xizmat ko'rsata oladi , aloqalar soni ,yozuv va o'qish proporsiayalariga asoslangan bo'lishi mumkin. Yuklama ortib borishi bilan u oxir-oqibat tizimning maksimal capacityga yetadi — tizim bardosh bera oladigan maksimal yuklama. Shu nuqtada, tizimning ishlashi pasayadi yoki yomonlashadi. Agar tizimdagi yuk o’sishda davom etsa, u oxir-oqibat ko’p operatsiyalar muvaffaqiyatsizlikka uchraydigan yoki vaqtga nisbatan ulgurmaydigan (timeout) nuqtaga etadi.
Distributed systemning sig’imi uning arxitekturasiga va qurilmalarning xotira hajmi , tarmoq ulanishlarining o’tkazish qobiliyati va kechikishi kabi murakkab tarmoq cheklovlariga bog’liq.
Imkoniyatlarni oshirishning tez va oson yo’li — bu yaxshi xotira va cpuga ega bo’lgan qimmatroq uskunani sotib olishdir, bu scaling up deb ataladi. Ammo bu ertami-kechmi oxiriga yetib boradi chunki bizda taminotlar cheksiz emas. Ushbu imkoniyat mavjud bo’lmaganda, tizimga qo’shimcha mashinalar qo’shish orqali kengayish scaling out deyiladi .
Chidamlilik (Resiliency)
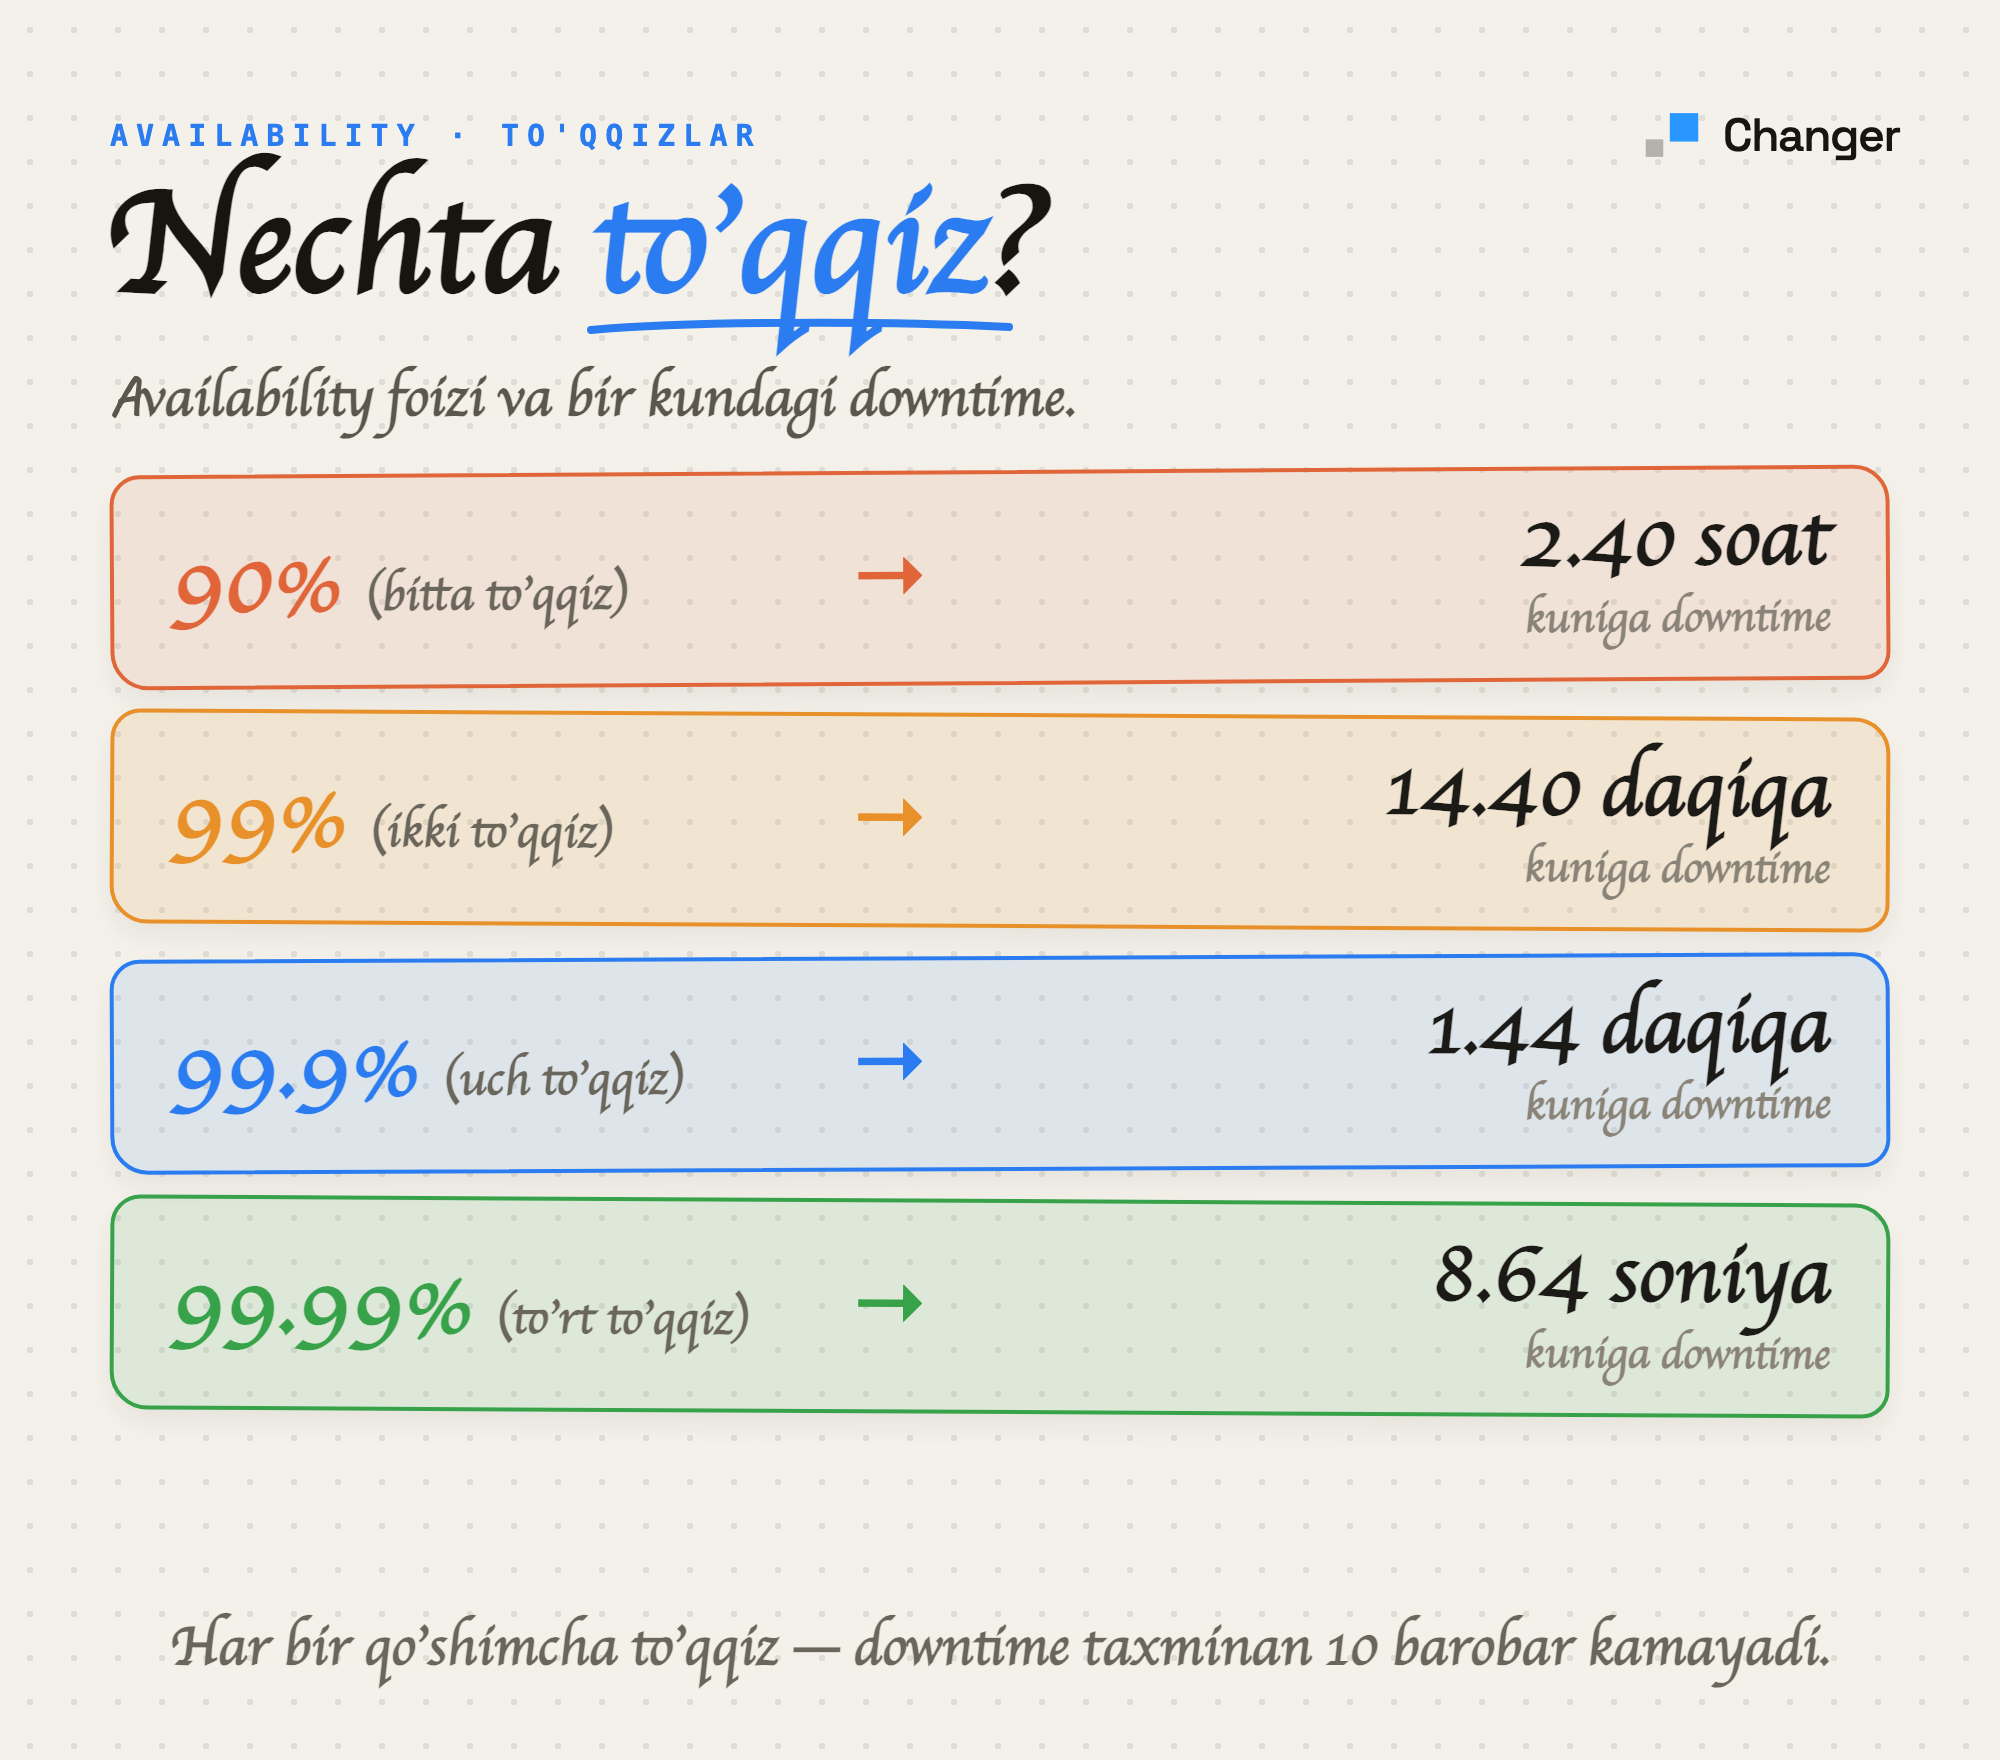
Distributed system hatto nosozliklar yuz berganda ham o’z ishini bajarishda davom etsa, Resilient system bo’ladi. Sodir bo’lishi mumkin bo’lgan har qanday muvaffaqiyatsizlik oxir-oqibat sodir bo’ladi. Tizimning har bir komponenti ishlamay qolishi ehtimoli bor — qurilmalar ishdan chiqishi, tarmoq ulanishlari uzilishi va hokazo. Bu ehtimollik qanchalik kichik bo’lmasin, qancha ko’p komponentlar mavjud bo’lsa va tizim qanchalik ko’p operatsiyalar bajarsa, shuncha ko’p bo’ladi. Muvaffaqiyatsizliklarning mutlaq soni ko’payadi. Va bundan ham yomoni, nosozliklar odatda mustaqil bo’lmagani uchun, komponentning ishdan chiqishi boshqa birining muvaffaqiyatsiz bo’lish ehtimolini oshirishi mumkin. Tekshirilmasdan qolgan nosozliklar tizimning availabilitysiga ta’sir qilishi mumkin, bu dastur so’rovlarga xizmat ko’rsatish vaqtining o’lchangan davr davomiyligiga bo’linishi sifatida aniqlanadi. Boshqacha qilib aytganda, bu tizim so’rovlarga xizmat ko’rsatish va foydali ishlarni bajarishga qodir bo’lgan vaqtning foizidir.
Mavjudlik ko’pincha to’qqizta bilan tavsiflanadi, bu mavjudlik foizlarini ifodalashning stenografiya usuli. Odatda uchta to’qqizta yetarli deb hisoblanadi va to’rttadan yuqori bo’lgan har qanday daraja highly available deyiladi.
Agar tizim nosozliklarga chidamli bo’lmasa, bu dastur ko’proq yukni ko’tarish uchun kengaygan sari ortib boradi, uning availability muqarrar ravishda pasayadi. Shu sababli, distributed systemda muvaffaqiyatsizlikni o’z ichiga olishi va o’z-o’zini davolash mexanizmlari (self-healing)kabi usullardan foydalangan holda uning ustida ishlashi kerak.
Muhandis sifatida siz paranoid bo’lishingiz va uning sodir bo’lish ehtimoli va bu sodir bo’lganda uning ta’sirini hisobga olgan holda komponentning ishdan chiqishi xavfini baholashingiz kerak. Agar xavf yuqori bo’lsa, uni kamaytirish kerak bo’ladi.
Operations
Distributed systemni sinovdan o'tkazish, serverga joylashtirish va ishlab turishini taminlash kerak. Odatda bir jamoa dastur ishlab chiqsa, boshqasi uni ishlatish uchun mas’ul bo'ladi. Mikroservislar va DevOpslarning ko’tarilishi buni o’zgartirdi. Tizimni loyihalash bilan shug’ullanadigan jamoa uning ishlashi uchun ham javobgardir. Bu yaxshi narsa, chunki o`zing yozgan koddan xatoni topish osonroq.
Yangi versiyalar tizimning availabilitysiga ta’sir qilmasdan xavfsiz tarzda doimiy ravishda chiqarilishi kerak. Tizim istalgan vaqtda nima bo’layotganini tushunish oson bo’lishi uchun kuzatilishi kerak.
Distributed system haqidagi umumiy tushunchalar shulardan iborat bo'lib bular eng yuqori darajadagi bilimlar va ichkari kirgan sari siz qiziqarli narsalarni ko'rib borishingiz mumkin.
E’tiboringiz uchun rahmat xato va kamchiliklar uchun uzr!!
Manba (batafsil o'qish uchun): Roberto Vitillo — Understanding Distributed Systems