Fail-over va fault tolerance nima? High availability asoslari
Assalamu Alaykum bugun sistemada xatolik yuz berganda qanday qilib uni foydalanuvchiga bildirmasdan hal qilishni o'rganamiz.
Fail-over
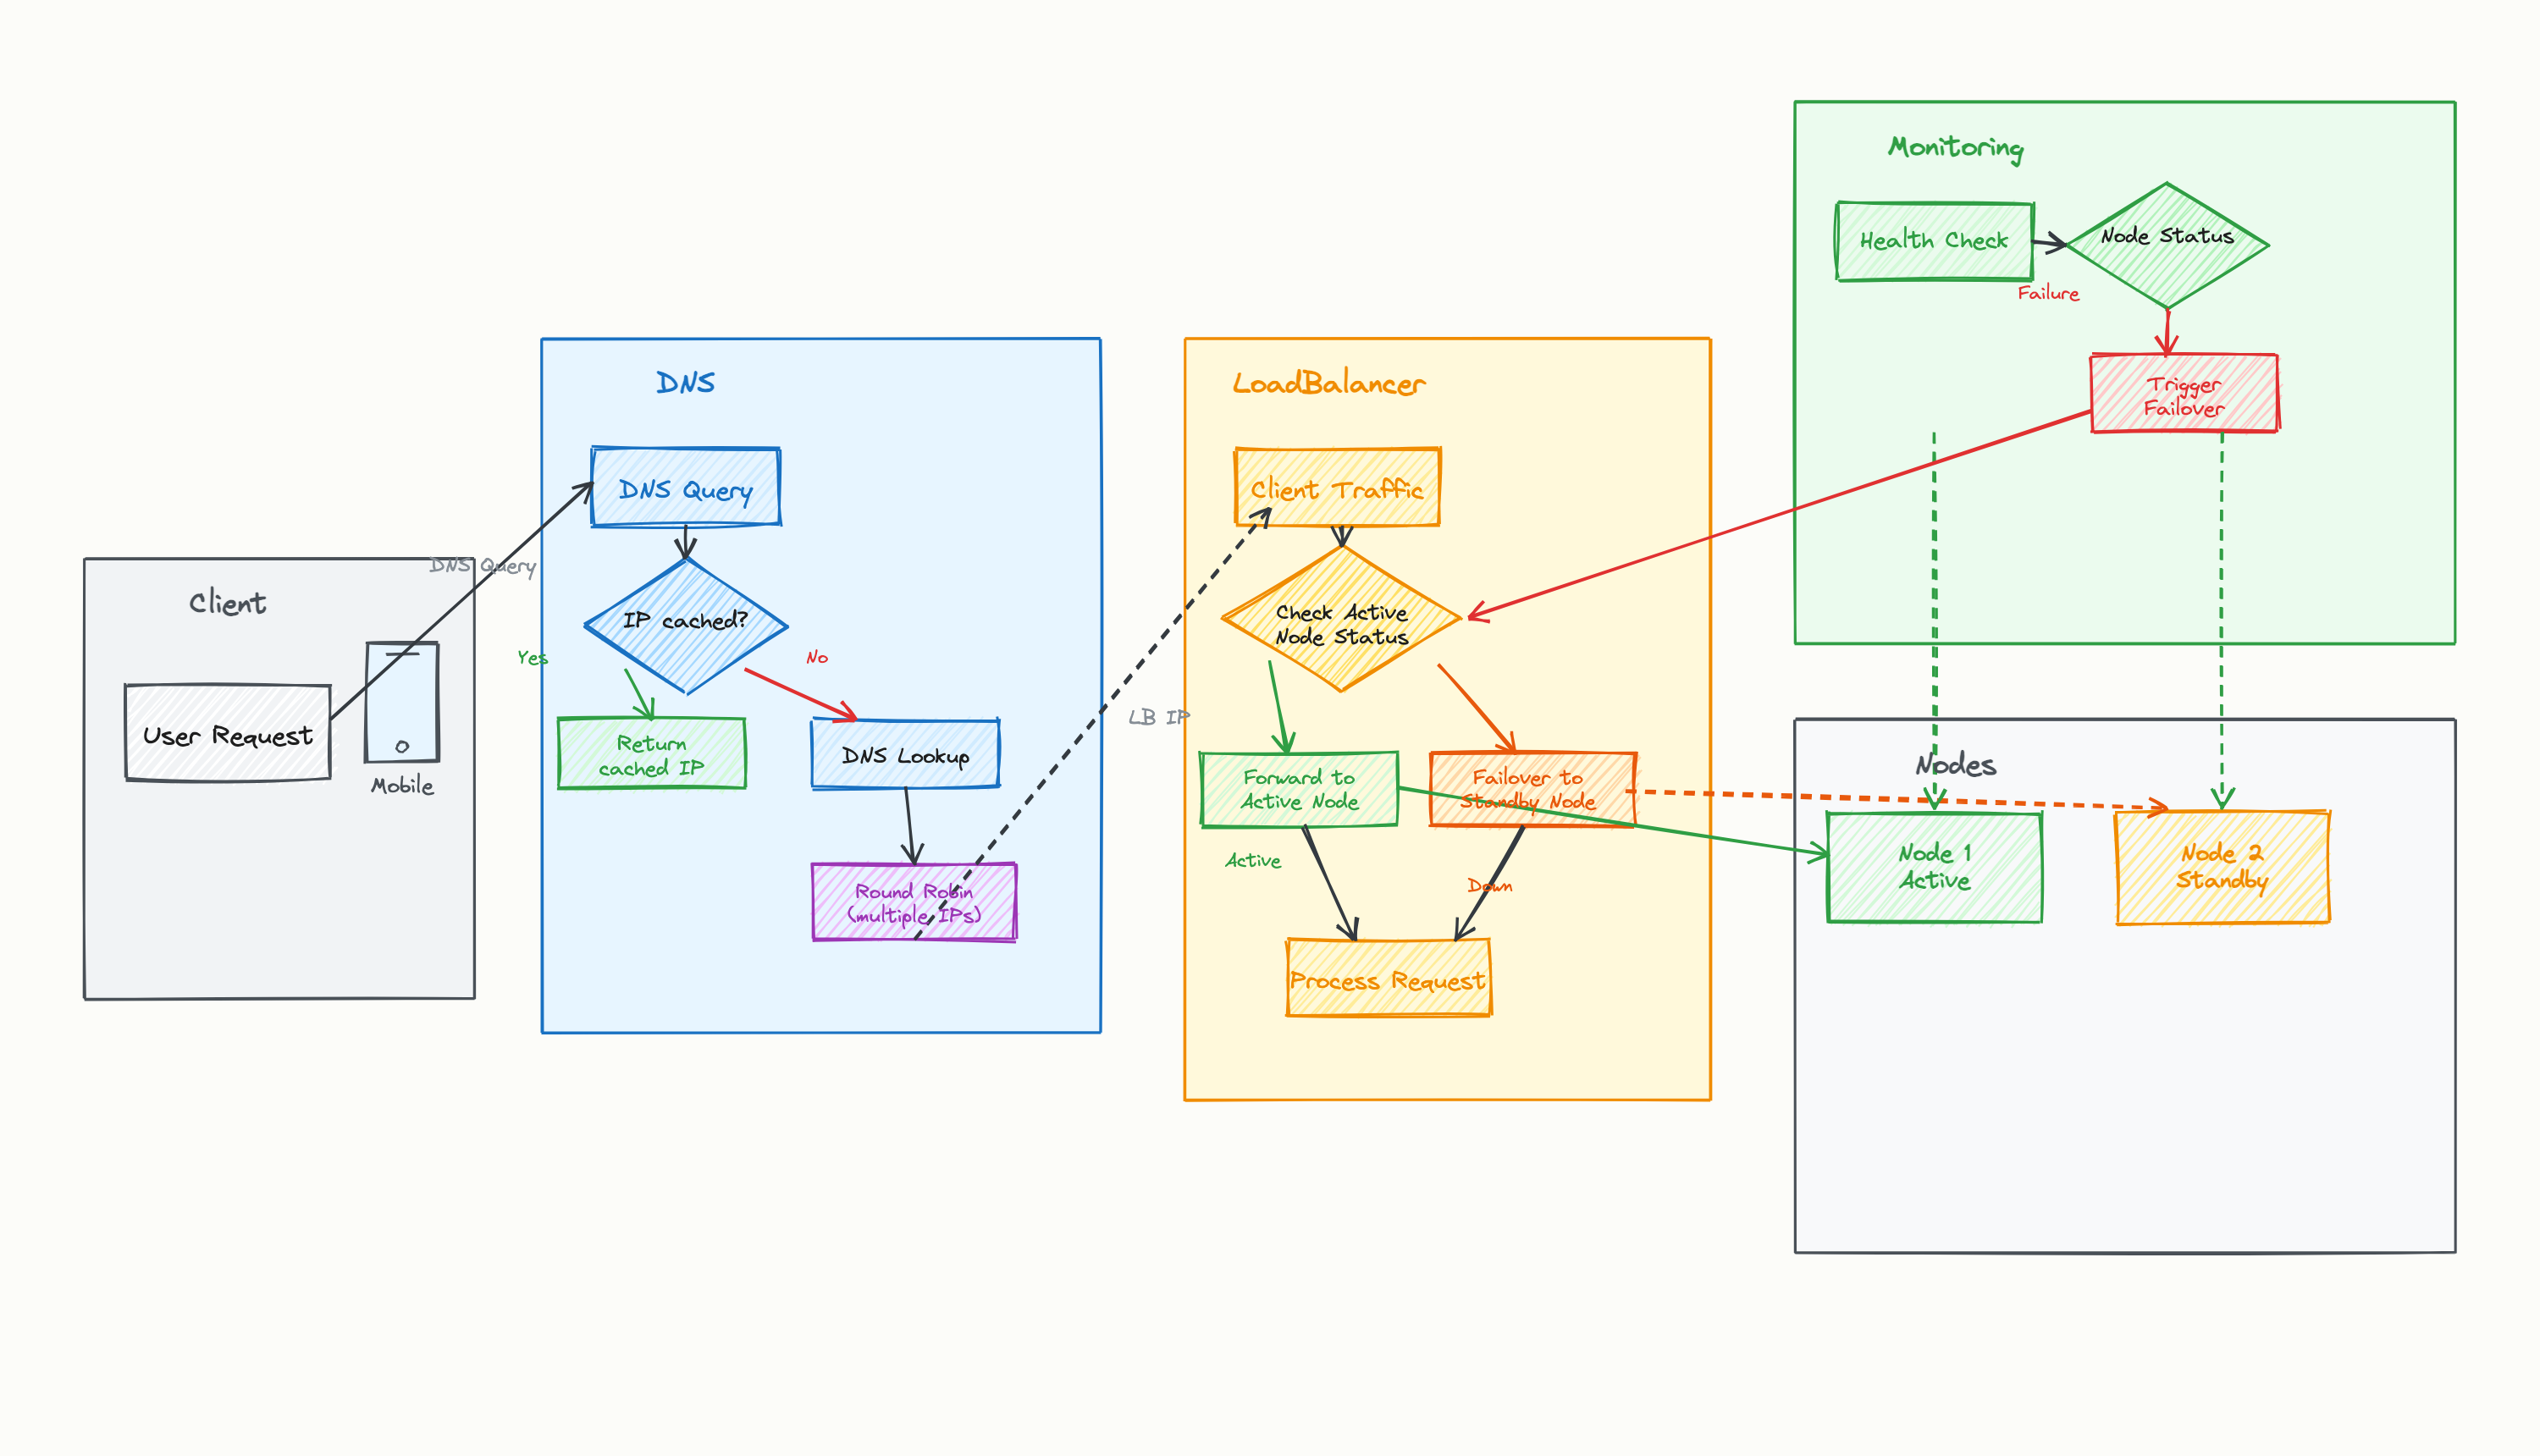
Fail-over deb zaxira(backup) tizimiga avtomatik va foydalanuvchiga bildirmagan holda o'tishga aytiladi. Asosiy server yoki biror komponent o'chib qolsa , standby yoki replica server o'rnini egallagan holda , foydalanuvchilarga bo'lgan ta’sirni kamaytirishi yoki yo'qotishi kerak.
Shuning uchun standby server har doim o'rniga kelish uchun tayyor bo'lishi kerak.
Fail-over avtomatlashtirish odatdaheartbeatga bog'liq bo'ladi , serverlar heartbeat orqali bir biri ishlayotganin bildirib turadi . Primary server doim aktiv bo'ladi va heartbeat o'chib qolsa standby o'rnini egallaydi va dasturchilarga primary qulagani haqida ogohlantirish yuboradi.
Fail-over qanday ishlaydi ?
High availability taklif qiladigan dasturlar uchun odatda active-active va active-standby konfiguratsiyalari ishlatilinadi. Har bir usul har xil failover texnikasidan foydalanadi ammo ,ikkalasi ham reliabilitini oshiradi.
Active-active uslubida kamida 2 ta node active bo'ladi va birgalikda bir xil xizmat ko'rsatayotgan bo'ladi . Bu uslubda load barcha nodelar orasida teng taqsimlanadi va node overload bo'lishidan saqlanadi , ko'p nodelar tayyor turgani uchun response time va throughput yaxshilanadi.
Active-standby uslubida kamida 2 ta nodedan tashkil topgan bo'ladi , hammasi ham aktiv bo'lmaydi . 2 ta nodelik sistemada 1-node aktive bo'lib, 2-node standby sifatida kutib turadi .
Active-standby uslubida standby doim ishlab tursa ham , foydalanish 0ga teng bo'ladi .Active-active uslubda esa load teng bo'linadi ammo har bir node butun loadga bardosh bera oladi.
Xatolik bo'lgan paytda active-active uslubda sistema ishlamay qolish vaqti 0ga teng bo'ladi, chunki 2 ta server ham ishlayotgan bo'ladi. Active-standby uslubida dastur ishlamay qoladigan vaqt bo'ladi chunki server boshqa nodega o'tishiga vaqt ketadi.
Fault tolerance (Xatolikka chidamlilik)
Fault tolerance bu xatolik sodir bo'lganda ham sistema bir xil yoki asosiy funksionalligini yo'qotmagan holda ishlab turishi.Bu dastur uchun juda muhim ayniqsa cloudda uptime juda muhim hisoblanadi . Bir necha daqiqa dastur ishlamay qolishi million dollorlab pul yo’qotishga olib keladi. Pul yo'qotmagan holda ham foydalanuvchi ishonchini yo'qotadi.
Masalan, quyidagi rasmda 2ta dastur databaza darajasidagi fault tolerance taqqoslash uchun ko'rsatilgan . 1-dastur bitta databazaga ulangan , 2-databaza esa replication qilingan va 2 ta databazaga ulangan.
Bu holatda 2-dastur ko'proq xatolikga chidamliroq (fault tolerant). Agar primary databaza o'chib qolsa , replica uning o'rniga odatdagidek ishlab turadi.
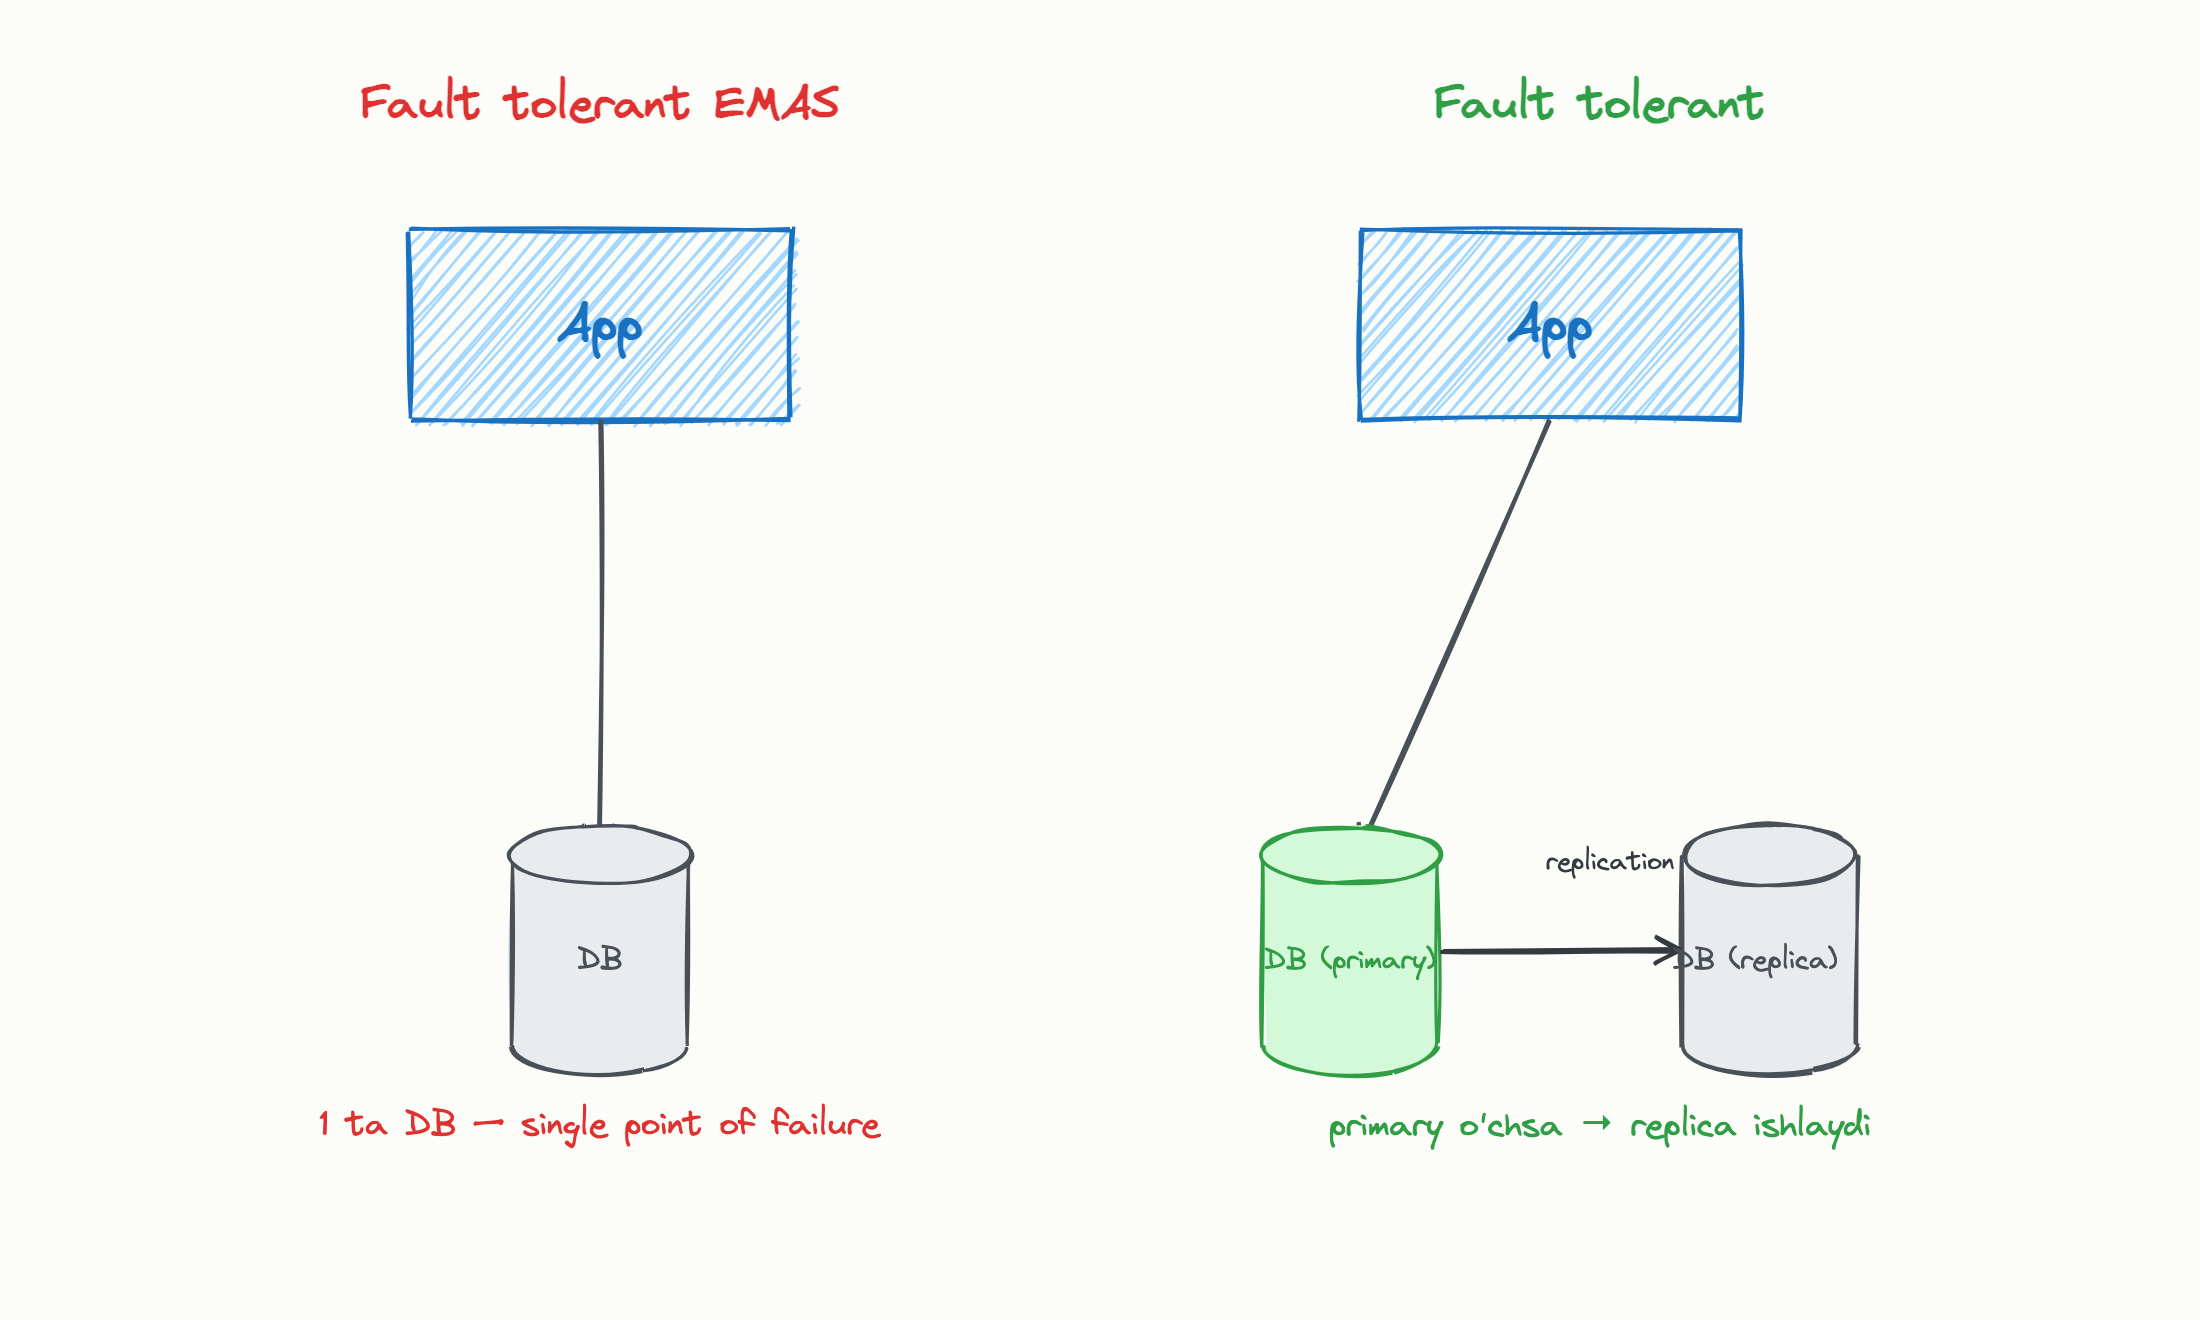
1-dastur xatolikga chidamli (fault tolerant emas) databaza o'chib qolsa dastur ishlamaydi . Buni single point of failure da ham ko'rib chiqqandik (link). Bu chidamlilikni oshirishni bir yo'li. Ammo hozirgi dasturlarda bu faqatgina databaza emas bu undan kattaroq narsa. Hozirda System design qilayotganda xatoliklardan avtomatik tiklanish va xizmatlarda iloji boricha uzulishlarsiz ishlash hisobga olinishi kerak. Bu foydalanuvchi ishonchini oshiradi va biznes doimiy ishlab turishi uchun muhim narsa.
Fault tolerance erishish uslublari
Bir xil ishni qila oladigan bir necha hardware ega bo'lish.Masalan tepadagi 2-dastur 2 ta turli xil databazalarni turli joylarda qo'yishi va bu orqali hardware failure yoki boshqa muammolar paydo bo'lgan paytda 2-databaza ishni davom ettirishiga erishish mumkin.
Bir ishni qila oladigan bir necha software namunalariga ega bo'lish. Masalan, bugungi zamonaviy dasturlarda konteynerlash ishlatilinadi va ular Kubernetesda ishga tushuriladi , shu paytda shu konteynerdan bir nechtasini ishga tushirish mumkin. Agarda birortasida xatolik kelib chiqsa trafik boshqa konteynerlarga yuboriladi.
Zaxira quvvat manbalari ega bo'lish , masalan generatorlar, dastur ob havo tufayli to'k o'chganda doimiy uzulishsiz ishlab turishini taminlaydi .
High availability va fault tolerance
Fault tolerance va high availability bu bir xil narsa emas . Dasturniy doimiy ishlab turishini taminlash va uni xatolikga chidamli qilish 2 xil narsa . Xatolikga chidamli dastur ham ba'zan o'chirilib yangilanishlar yoki databazadagi sxemalar o'zgartirilishi mumkin.
Fault tolerancega erishish uchun ko'proq pul to'laymiz va dastur murakkablashadi.
Fault tolerant sistema qurganda xatolik bo'lgan payti sizda dastur to'liq funksionalligi saqlab qolgan holda ishlashi mumkin bu normal holat. Ammo bizda graceful degradation yo'lini tanlashimiz mumkin . Bunda xatolilar funksionallikga ta'sir qilgan holda , foydalanuvchi dasturdan to'liq foydalana olmaydi lekin dastur to'liqligicha o'chib qolmaydi. Masalan pul o'tkazish tizimidagi holatda , karta ochish, qo'shish va buyurtma berishlar to'xtatilgan holatda ammo pul o'tkazmalari va kommunal to'lovlarni amalga oshirish mumkin bo'ladi.
Ishlab turish maqsadlari
Ishlab turish maqsadlari har xil bo'lishi mumkin va turli xil chidamlilikni taklif qiladi :
Node xatoliklarida ishlab turish.Bir dasturni bir data centerdagi bir necha nodelarda ishga tushirish (odatda boshqa boshqa serverlarda) . Bu bizga hardware xatoliklari tizimga ta'sir qilishini oldini oladi.
Data center o'chib qolishida ishlab turish.Dasturni bir necha data centerlarda ishga tushurish , sizga tabiiy ofatlar paytida data center o'chib qolganda ham ishlab turishga yordam beradi.
Mintaqadagi o'chib qolishlarda ishlab turish. Dasturni bir necha mintaqalarda ishga tushurish va siz mintaqadagi xatolilardan qutulib qolasiz.
Cloud providerlar o'chib qolishida ishlab turish. O'zingizni serverlaringizni cloud bilan birgalikda ishlatib turish , sizga cloud qulaganda ham xizmat ko'rsatishga yordam beradi.
Xulosa
Xulosa qilib aytadigan bo'lsakfail-overvasingle point of failureni aniqlash va shu kabi uslublar sistemani har xil xatoliklar tufayli o'chib qolmasligini taminlaydi .