Row va column oriented databazalar: OLTP va OLAP farqi
Assalamu Alaykum bugun Row(qator) va column(ustun)ga asoslangan databazalar ma’lumotni qanday saqlashi va qaysi querylar uchun qaysi biri qulayligini ko'rib chiqamiz.
Bugungi maqolamizda:
— Row oriented (row store) databaza
— Column oriented (column store) databaza
— Afzalliklari va zararlari
Bugungi foydalanadigan querylarimiz va ularning holati:
— Indexsiz
— SELECTfirstname FROMstudent WHEREstudent_id = 2000;
— SELECT* FROMstudent WHEREstudent_id = 400;
— SELECT SUM(debt) from student ;
Row oriented databazalar (OLTP)
Row orianted databazalarda pagedagi ma’lumotlar qatorma qator saqlanadi ya’ni birinchi qator , keyin ikkinchi qator va birgina I/O bir necha rowni va uning ichidagi hamma ma’lumotni olib keladi .Bu holatda bizga aniq rowni topishga bir necha I/O ketishi mumkin ammo topilganda hamma ma'lumot bo'ladi.
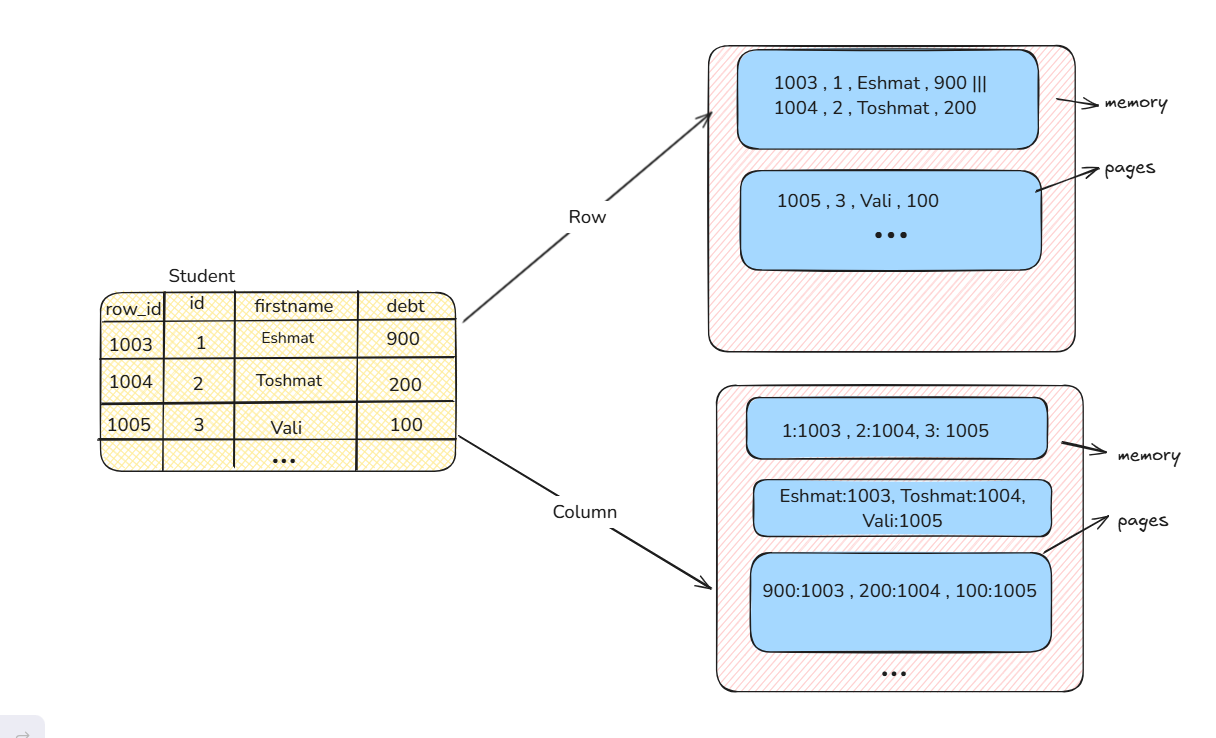
Query bilan tekshirishni boshlaymiz 1-chi querimiz SELECTfirstname FROMstudent WHEREstudent_id = 2000 . Bu holatda biz jadvalni boshidan tekshirishni boshlaymiz toki 2000 idlik talabani topgancha va shu rowdagi firstname ma'lumotini qaytaramiz.
Keling SELECT* FROMstudent WHEREstudent_id = 400 queryni ishlatib ko'ramiz. Tepadagidik bu holatda ham tekshirish tepadan boshlanadi va topilgan rowdagi hamma ma'lumot uzatiladi.
Endi SELECT SUM(debt) from student queryni ishlatib ko'ramiz, bunda databaza jadvaldagi hamma ma'lumotni olib debt qiymatini qo'shib chiqib qaytaradi.
Column oriented databaza (OLAP)
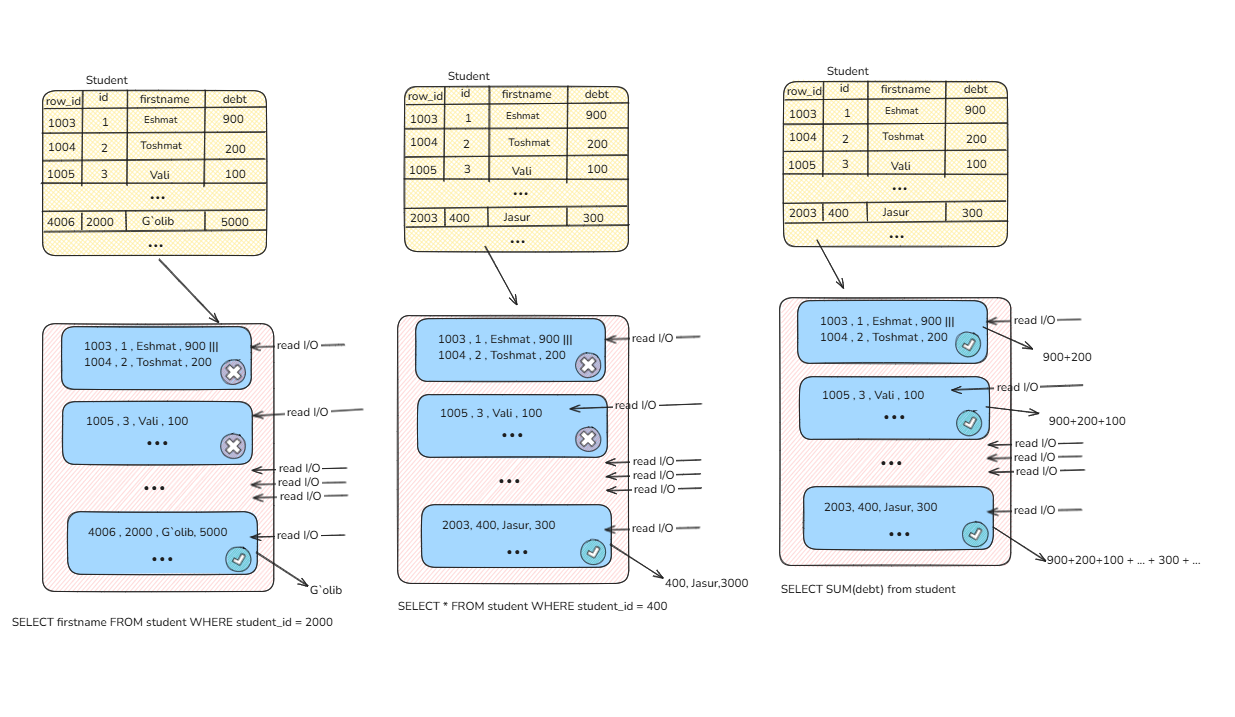
Column oriented databazalarda ma’lumotlar ustunlar bo'yicha saqlangan bo'ladi . Masalan hamma firstnamelar birinchi keyin idlar, keyin debtlar . Bitta I/O orqali bizga kerakli rowlardagi bir necha ustun ma'lumotlarini o'qishimiz mumkin (kam I/O orqali kerakli ma'lumotni olish) ,ammo bir necha column bilan ishlash ko'p I/O talab qiladi.
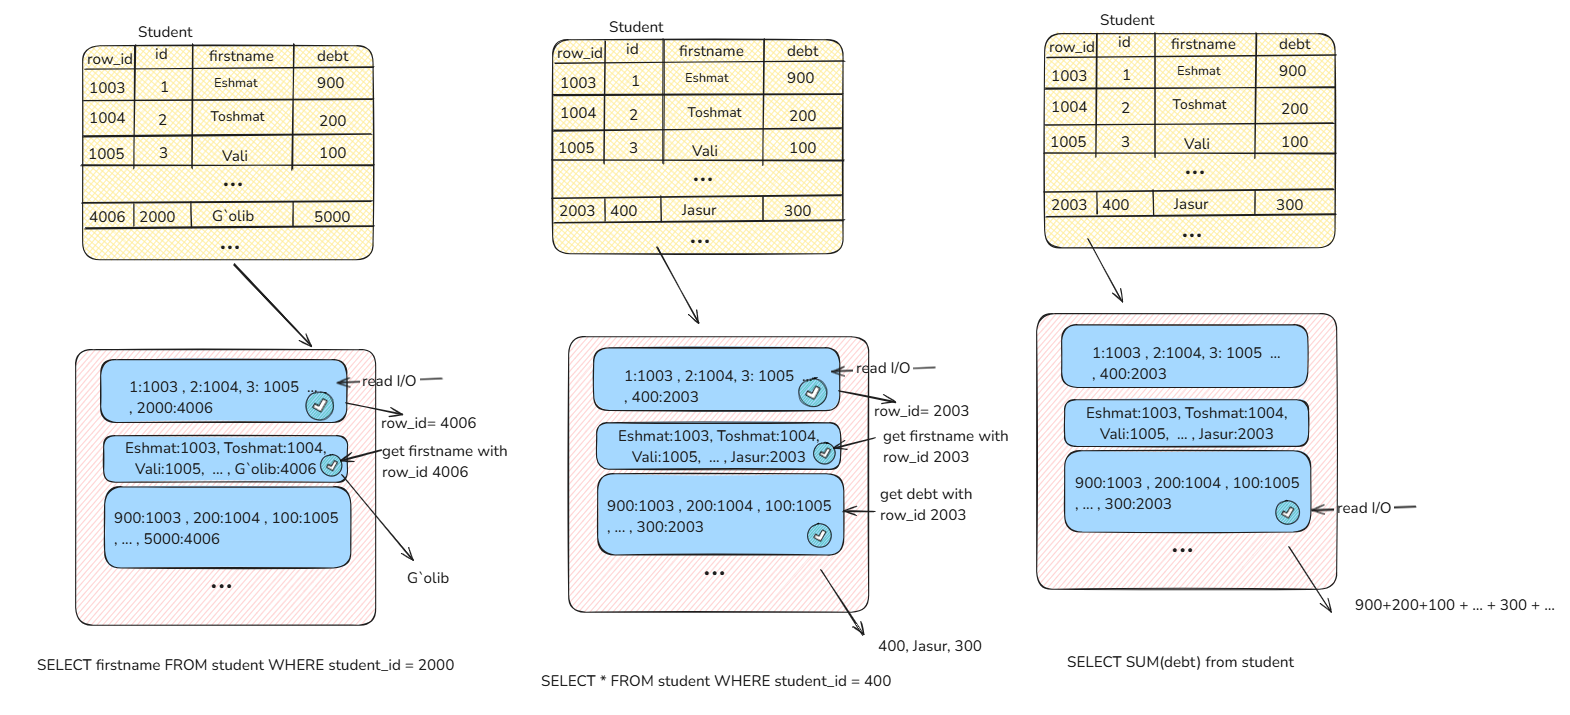
Tepadagi rasmdan ko'rib turganingizdek row_id allaqachon 2 martadan saqlangan, agarda siz biror rowni o'chirish yoki bir necha qismiga o'zgartirish kiritsangiz bu juda ko'p joyda o'zgarish talab qiladi .
Tepadagi rasmda xuddi rowga asoslangan querylar columnga asoslangan databazada qaysi operatsiyalar amalga oshirishi ko'rib chiqilgan va column databaza asosan aggregate funksiyalarda optimal tez ishlaydi chunki faqat o'sha pagega I/O bo'ladi.Hozir bu yerda kam ustunlar(column bo'lganligi tufayli column optimal ko'rilmoqda siz uni 10+ ustunlik jadvallarda yaqqol rowga asoslangandan ortda qolayotganini ko'rasiz.
Columnga asoslanga databazalarda compressionham bo'ladi masalan bir xil qarzdagi bir necha id birdaniga bitta qarz ma'lumot oldida saqlanadi. Bu hozir postgresda ham qisman ishlaydi .
Bu yerda bizda bir savol bor agar rowga asoslangan jadvalga yangi column qo'shilsa nima bo'ladi yoki columnga asoslangan databazaga yangi row qo'shilsa ?
Xo'sh agarda siz yangi column qo'shib unga defaultqiymat bermasangiz , bu databaza uchun osonroq chunki pagelar o'zgarmaydi , bu columnni olmoqchi bo'lsangiz siz NULLqabul qilasiz , postgres shunchaki metadatalar orqali shu column haqida ma’lumotga ega bo'ladi hattoki u pagelarda saqlanmagan bo'lsa ham. Agarda siz null bo'lmagan column qo'shib unga default qiymat bersangiz , bu butun jadvalni qayta yozishga sabab bo'ladi va pagelardagi ma’lumotlar yana qayta taqsimlanadi bu juda qimmat operatsiya bo'ladi.
Xuddi shunday columnga asoslangan databazada yangi row qo'shilganda shunchaki har bir column pagega yoziladi, agarda yangi column qo'shilsa agarda null bo'lmasa shu column uchun yangi pagelar ochiladi.
Shuning uchun yangi column qo'shayotganda qanday bo'lishini tanlash backend dasturchini qo'lida va dasturni bir xil xatolarsiz ishlab turishiga javobgar. Agarda unga default qiymatlar kerak bo'lmasa null ishlatilgani maqul.
Xulosa
Xulosa qilib aytadigan bo'lsak row based querylar tranzaksiyalik va ko'p operatsiyalik dasturlarda ishlatish qulay masalan OLTP (Online Transaction Processing)dasturlarda, columnga asoslangan databazalar tepada ko'rganingizdek OLAP (online analytical processing)analitikaga asoslangan dasturlar uchun qulay chunki ular qaysidir column ustida ko'proq ishlaydi. Ammo bazi databazalar hozi hybrid usulni ham taklif qilishmoqda.