B-Tree va B+Tree nima? Index tezligini qanday oshiradi
Assalamu Alaykum bugun o'sha mashhur databazadagi B tree nima uchun ishlatilinishi va uni foydalari haqida gaplashamiz. U haqida boshlang'ich ma'lumot index maqolasida berilgan.
Databazadagi indexlar haqida to'liq ma’lumot.
Xo'sh birinchi bo'lib B Tree qaysi muammoni yechish uchun ishlatilinishini ko'ramiz . Agarda bizda hech qanday indexlar bo'lmasa kerakli ma'lumotni topish uchun jadvaldagi bor ma'lumotni ko'zdan kechirib chiqishimiz kerak bu Full table scan (sequential scan) deyiladi .
Bu holatda bizda ushbu muammolar mavjud:
Biz o'zimizga kerak bo'lgan qatorni(row) topguncha jadvalni to'liq tekshirishimiz kerak.
Katta jadvalni o'qish sekin bo'ladi.
Hamma pagelarni o'qib olish juda ko'p I/O talab qiladi.
Shuning uchun biz buni kamaytirish yo'llarini topishimiz kerak va buni B-Tree yechadi .
B-TREE
B-Tree bu tez qidiruvni amalga oshirish uchun balanslangan data strukturasi , asosiy maqsadi qidiriladigan sohani kichraytirish. B-Tree nodelardan tashkil topgan , hamda unda daraja ham bor biz buni dasturlashda “m”deb ataymiz va treega ta'sir qiladi. Aslida buni databaza biz kiritayotgan ma'lumotlarga asoslanib o'zi tanlaydi (biz uni konfiguratsiya qilolmaymiz) .Daraja bir ota(parent) nodeda nechta bola (child) node bo'g'lana olishini bildiradi.Nodeda m-1 ta element bo'ladi. Element bu — indexlar qiymati ya’ni u key va valuedan tashkil topgan va value bu qatorga olib boradigan pointer bo'ladi odatda(databazaga bog'liq).Pointer to'g'ridan to'g'ri primary key yoki tupleIdga ko'rsatishi databaza implimentatsiyasiga bog'liq. Hamda bu yerda root node, internal node va leaf nodelar ham bor. Root node bu tree boshidagi node leaf node esa eng oxirgi child nodelar, internal nodelar bu root va leaf nodelar orasidagi nodelardi .Ko'p databazalarda 1 node bu 1 pagega teng bo'ladi.
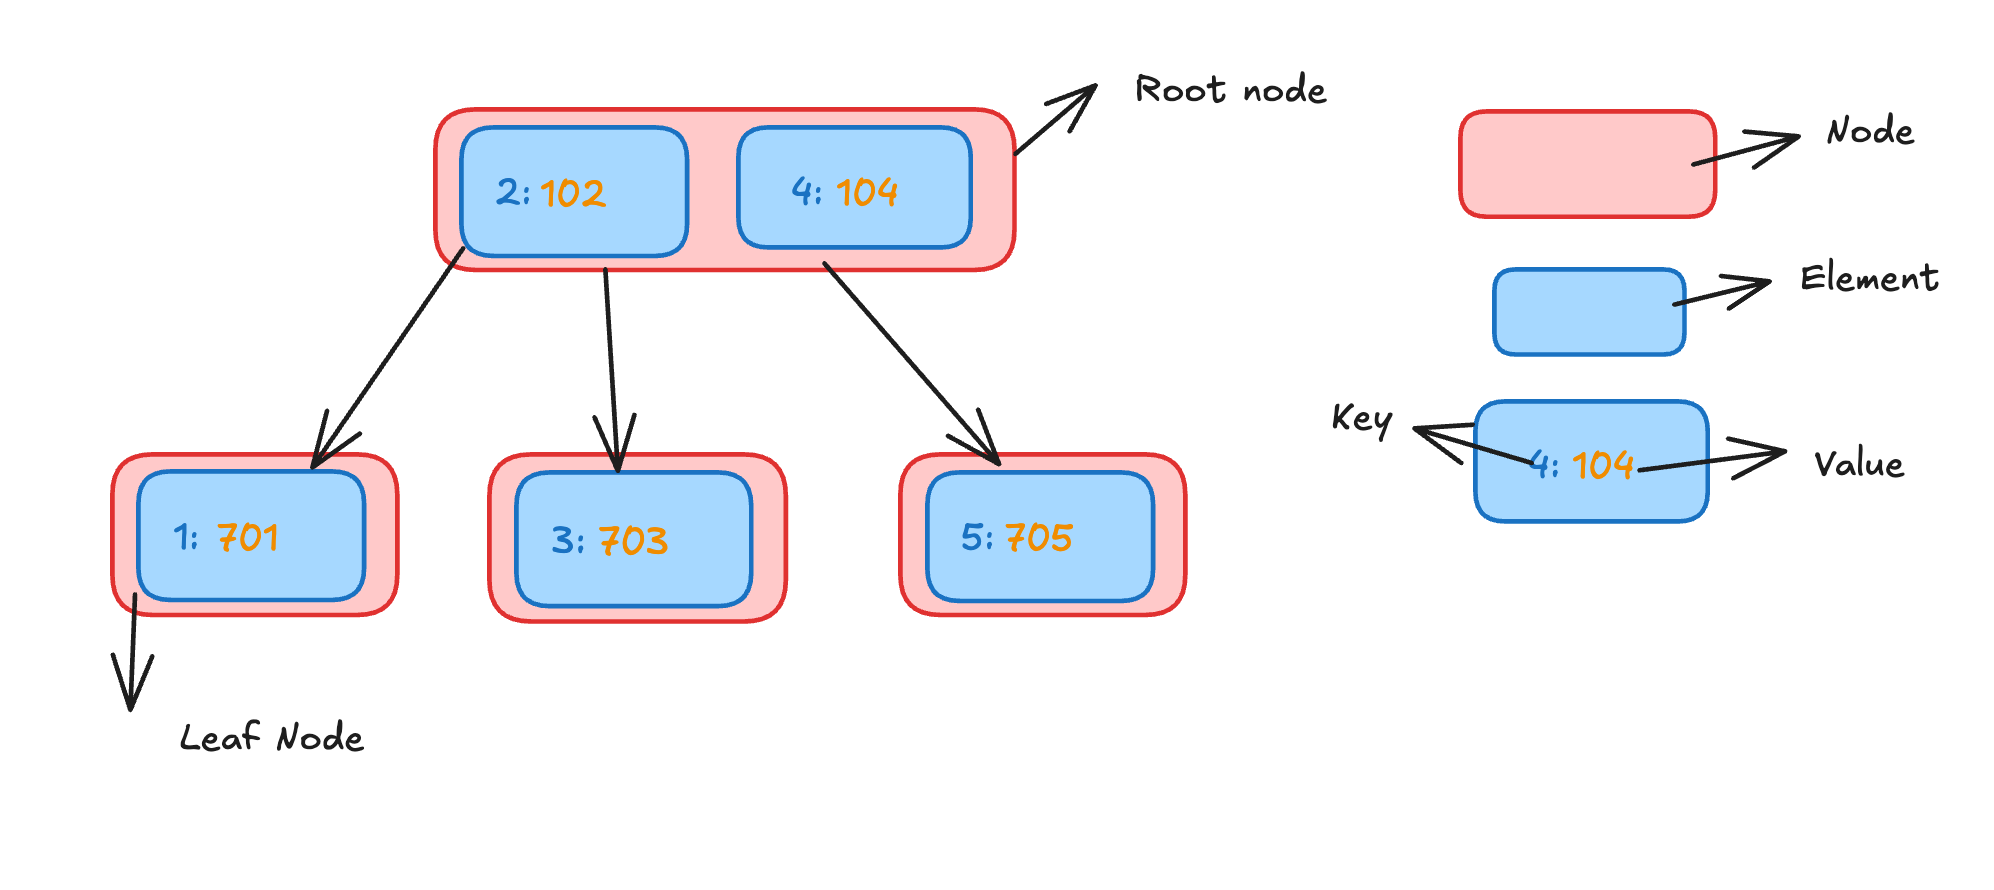
Databaza B-Tree darajasini keyning hajmiga qarab ya’ni siz indexlashga bergan ustun o'rtacha qiymatiga hamda pagening hajmiga moslagan holda belgilaydi (1 node pagega sig'ishi uchun).Siz aniq bir B-tree darajasini belgilolmaysiz ammo optimal yo'lda hisoblashingiz mumkin. Sizda aniq bir qiymatli page hajmi va unga nechta key sig'ishini hisobga olib.
Masalan, B-Tree 32 bitlik integer uchun indexlangan , va page hajmi esa 8 kb , va B-Tree darajasi 8KB/4 bytes , 2048 atrofida va page header uchun hajmni olib tashlaymiz va boshqa bir nechta factorlar orqali taxminiy raqamni hisoblash mumkin.
Biz bir pageni o'qiganda iloji boricha ko'p ma'lumot olishni xohlaymiz. Shunchaki 2ta element uchun page ochish sizga qimmatga tushadi , qachonki sizda faqatgina shu 2 ta element bo'lmasa.
B-Tree qanday qilib performanceni oshiradi ?
Pastdagi rasmdan ko'rib turganingizdek siz nodedan pastga qarab tushib borganingiz sari , elementlar ma'lum qoida asosida tartiblangani tufayli, sizni qidiruv hududingizdagi elementlar soni keskin qisqaradi va siz o'zingizga kerakli ma'lumotni tezroq topish imkoniyatiga ega bo'lasiz.
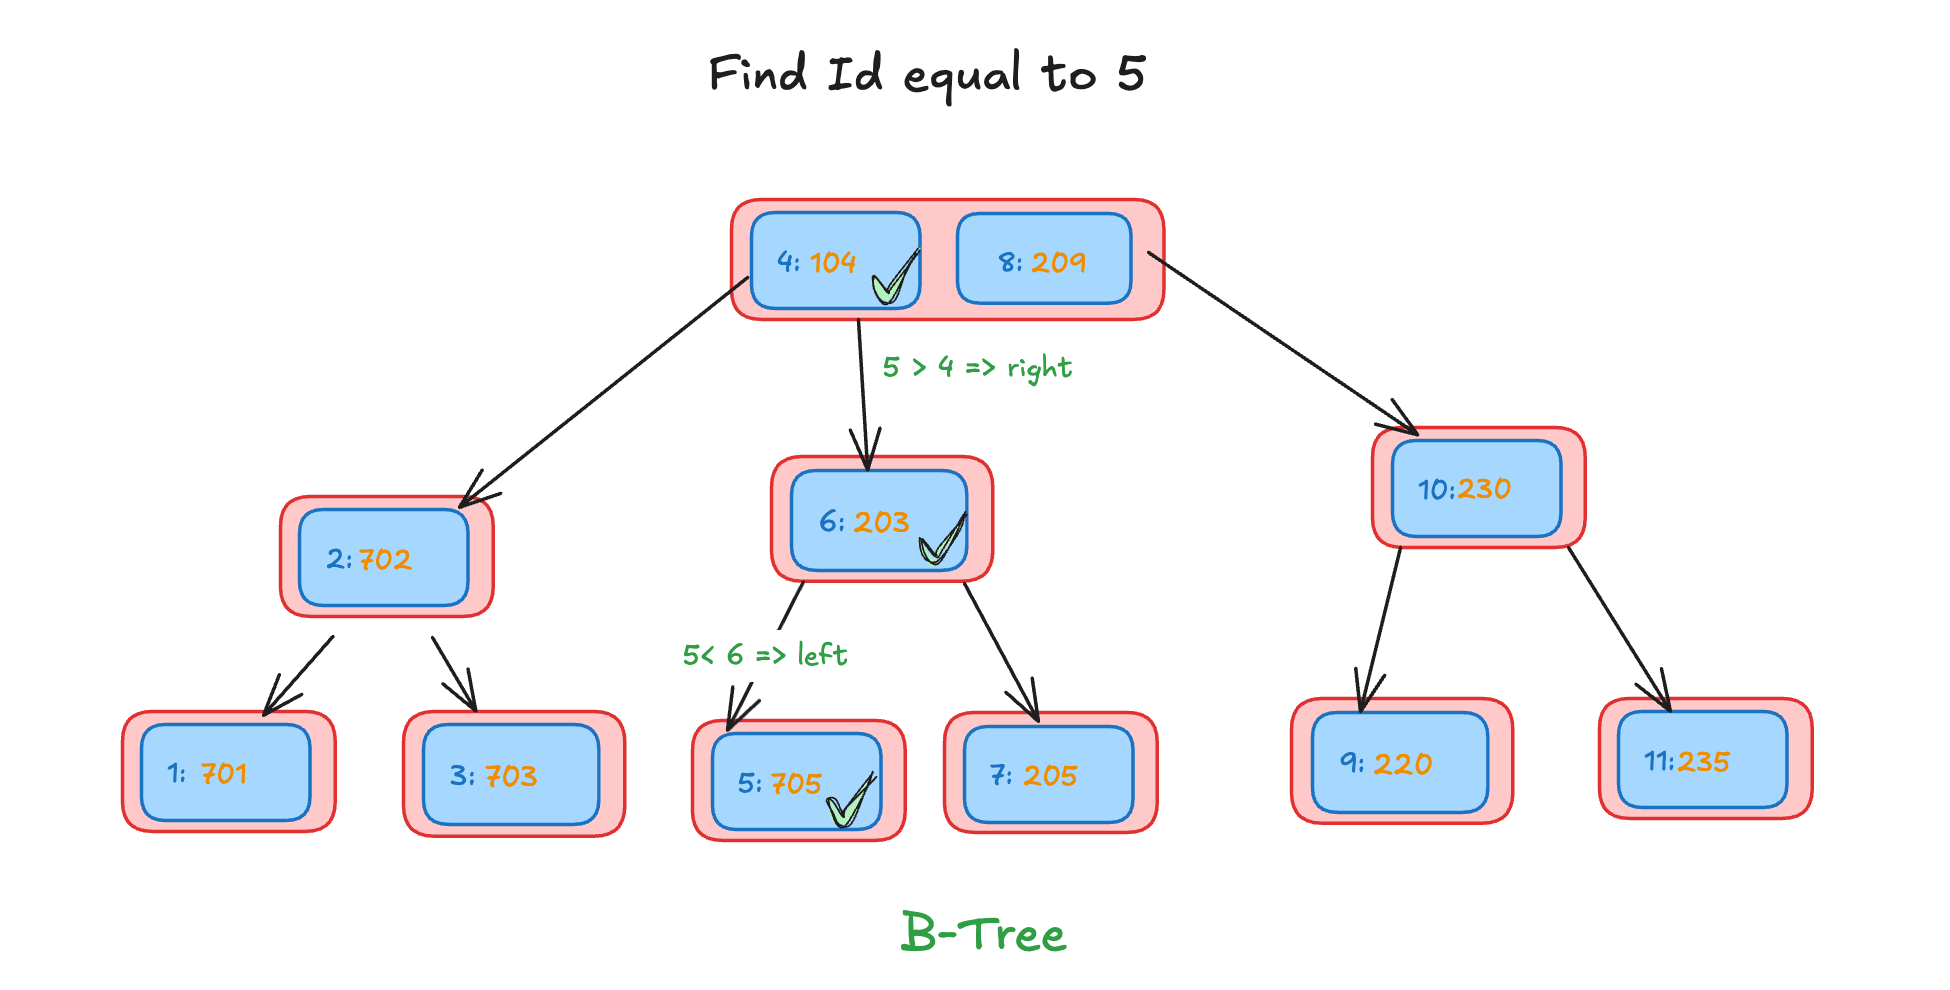
Bir nodeda bir nechta element bo'lishi mumkin masalan 10 va undan ko'proq. Ammo ma'lumot qo'shish sekinlashadi chunki bazi holatlarda siz pagelarni bo'lib , ma'lumotlarni qo'shishingizga to'g'ri kelishi mumkin.
B-Tree limitlari
B-Tree da har bir element o'zida key va valueni birgalikda saqlagani tufayli u juda ko'p xotirani oladi. Va biz juda ko'p ma'lumotni bir pagega sig'dirolmaymiz , va agarda pageda kam element bo'lsa demak biz ko'p page o'qishimizga to'g'ri keladi, ko'p I/O bu sekin degani.
Hamda range querylar ham sekin bo'ladi chunki u B treening har joyida bo'lganiligi tufayli hamma qiymatni topish sekinlashadi.
Bu 2ta muammoni yechish uchun B+Tree topilgan
B+Tree
B+Tree lar xuddi B-Treelardek ammo bir necha o'zgarishlar bilan , masalan ular root va internal nodelarda faqatgina key qiymatlarini o'zini saqlashadi. Hamma qiymatlar esa faqatgina leaf nodelarda bo'ladi va bu bizda internal nodelarda ko'p ma'lumot (key) sig'dirish uchun joy ochib. beradi.
Hamda leaf nodelar o'zidan keyingi leaf nodega pointer orqali ulangan bo'ladi , buni yordamida siz 1 qiymatni topganingizdan so'ng undan keyingi yoki oldingi qiymatlarga bemalol o'ta olasiz va bu range querylar tezroq ishlashiga yordam beradi. Agarda siz omadli bo'lsangiz balkim qidirayotgan qiymatlaringiz 1 pageda bo'lishi mumkin (page juda ko'p qiymatlarni saqlaydi) va bu faqatgina 1 ta I/O bo'ladi.
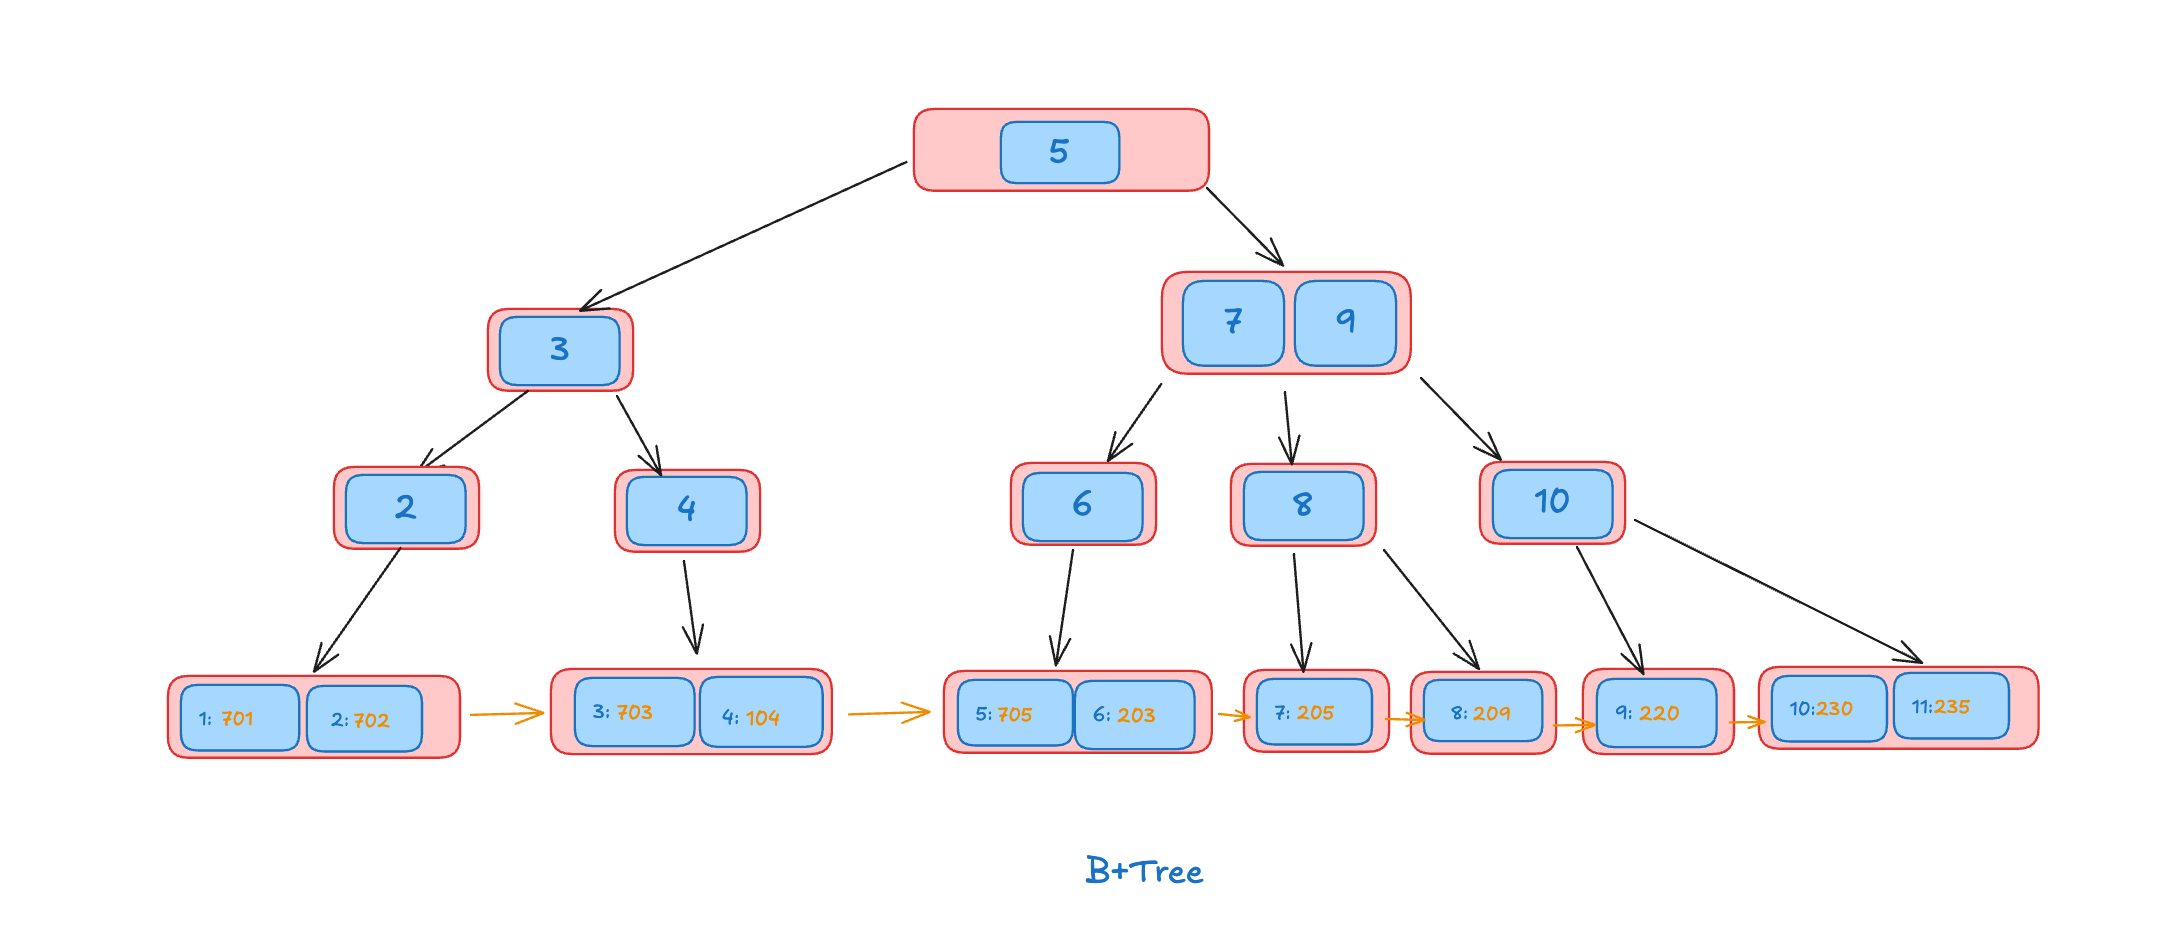
B+Tree va DBMS hisobgan olgan narsalar
Bizda leaf nodelarni bog'lash uchun ishlatilgan pointer ishlashi uchun keladigan qiyatni hisobga olish . 1Node DBMSning 1 pagega sig’ishi. Faqatgina key saqlangani uchun internal node ko'p ma'lumot olishi va natijada leaf node heapda saqlash mumkin.
Oldingi maqolalarda ko'rganimizdek biz B-tree ishlatamiz deyilgan ammo haqiqatda ular ko'pincha B+Tree ishlatishadi.
MySQL va POSTGRES o'rtasidagi xotira ishlatishdagi farqlar
●B+Treedagi secondary index qiymatlari to'g'ridan to'g'ri tuplega (Postgres) yoki primary keyga(MySQL) yo'naltiriladi. TupleId odatda kichik hajmni oladi ammo agarda primary key uuid bo'lsa u juda katta bo'ladi va barcha secondary indexlar unga yo'nalsa xotiradan ko'p joy olinadi va bu siz ishlashingiz uchun qiyin bo'lishi mumkin (MySQL).
●MySQL (InnoDB) Leaf nodelar to'liq qatorni o'z ichiga oladi chunki ular IOT / clustered index bo'lganligi uchun .
Xulosa
Xulosa qilib aytadigan bo'lsak B-Tree bizga qidiruv maydoni kichraytirib ma'lumotni tez topishga yordam beradi ammo ba’zi kamchiliklarga ega. Bu kamchiliklar esa B+Treeda yopilgan va bizga kerakli barcha xususiyatlarga ega.