Scalability nima? Vertical va horizontal scaling
Assalamu Alaykum bugun System designdagi eng muhum mavzularidan biri scalability(kengaytirish) mavzusini o'rganmiz . Buni bir serverda boshlangan dasturni kengaytirish va kelib chiqqan muammolarni yechish bilan ko'rib chiqamiz.
Scalability
Bizga nega scalability kerak , chunki bugun yaxshi ishlab turgan dastur ertaga ham yaxshi ishlaydi degani emas bunga sabablar foydalanuvchilar ko'payishi yoki kelayotgan ma'lumotlar oqimi ko'payishi bo'lishi mumkin.
Scalability - sistema kengaygan yoki o'sgan sari(dastur qiyinlashuvi, ma'lumot ko'payishi) uni hal qilish mumkin bo'lgan to'g'ri yo'llar bo'lishi_. Scalable dastur degani bu kelayotgan loadga moslab oson konfiguratsiya qilinadigan dasturlarga aytiladi . Load har xil bo'lishi mumkin.
Dasturni scale qilishimiz uchun uning hozirgi loadini aniqlashimiz kerak va u 2 marta ko'paysa nima bo'lishini o'ylashimiz kerak. Load parameterlari sistema arxitekturasiga ko'ra har xil bo'ladi u sekundiga nechta requestga javob bera olishi yoki cachedan qancha ma'lumot olayotgani (cache hit) .
Performance yoki load parameterni tushunish uchun ushbu 2 savolni so'rash kerak:
Dasturda resurs o'zgarmagan holda load oshsa performancega qanday tasir qiladi.
Dasturga load oshganda oldingi performanceda turishi uchun resurslarni qanchaga oshirish kerak.
Bu 2 holatda ham bizga raqamlar kerak. Masalan batch processingda throughput asosiy load parameter - sekundiga nechta yozuvlarni(image, text) qayta ishlay oladi, online sistemalar uchun javob vaqti muhim bu foydalanuvchi serverga yuborgan vaqtdan toki undan javob kelishiga ketguncha bo'lgan vaqt . Odatda latency va response time bir xil ishlatiladi ular aslida ikki xil narsa response time bu so'rov foydalanuvchi tomondan chiqib javob qaytib kelguncha ketgan vaqt, latency esa bu so'rov serverga borib undan qaytib kelishiga ketadigan vaqt ya’ni server so'rovni process qilishni o'z ichiga olmaydi.
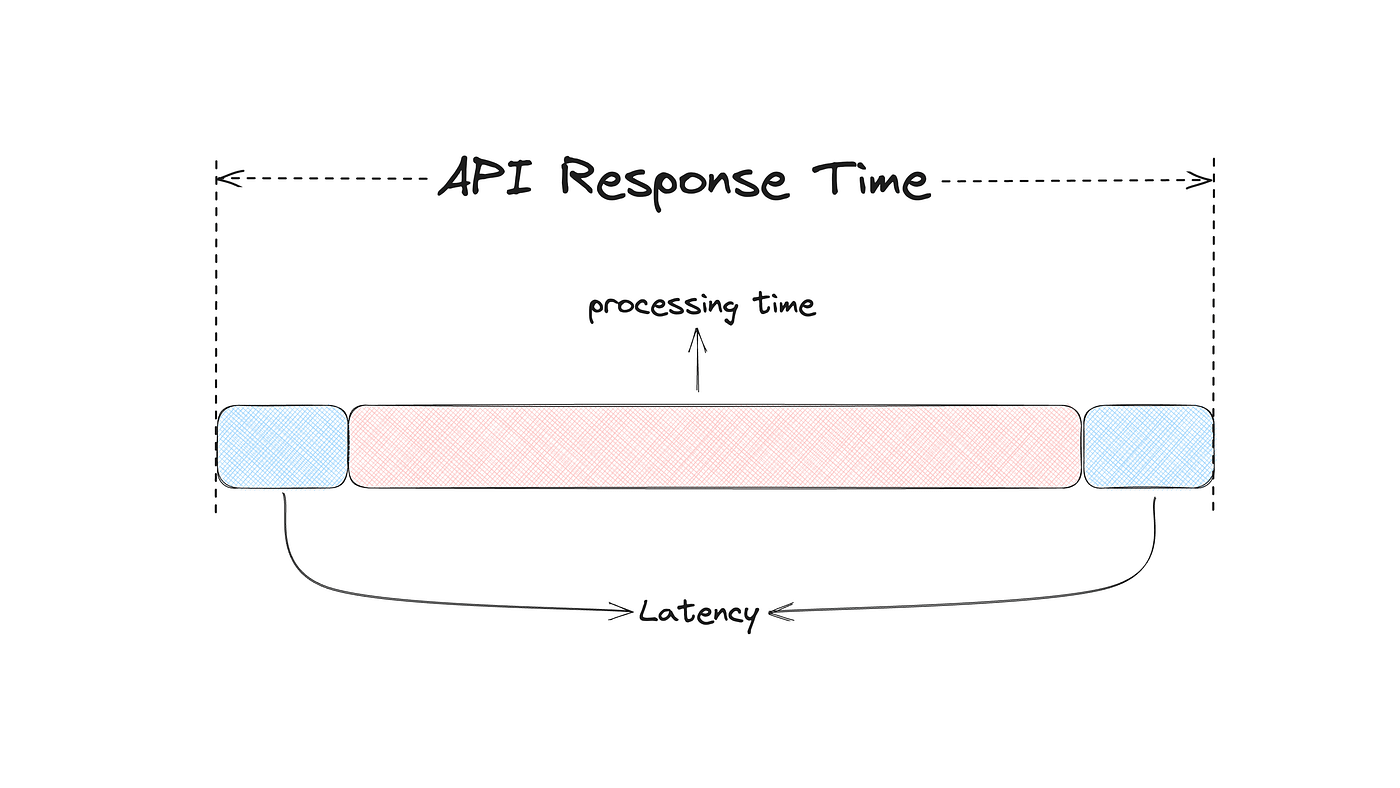
Response time har bir request uchun har xil bo'lishi mumkin shuning uchun biz unda o'ratacha raqamni olib ishlatamiz , ya’ni sizga keladigan so'rovlarni yarmiga undan ko'p vaqt ketadi yarmiga esa undan kam vaqt.
Performance vs scalability
Agarda resurs qo'shilishiga qarab proportional performance oshsa bu service scalable hisoblanadi. Performance oshishi bu ko'pchilikda xizmat ko'rsatishi yoki kattaroq hajmdagi ma'lumotlar bilan ishlay olish.
Performance va scalabilityiga boshqacha qaraganda:
Agarda sizda performance muammosi bo'lsa , sistema bir foydalanuvchi uchun sekin ishlaydi.
Agarda sizda scalability muammosi bo'lsa , sistema bir foydalanuvchi uchun tez ammo ko'p foydalanuvchi bilan sekinlashadi.
Latency(response time) vs throughput
Latency va response time haqida tepada gaplashdik . Throughput esa bir vaqt ichida shu harakatlardan nechtasini amalga oshirish mumkinligi. Odatda dastur minimal latency bilan ishlaydigan , maximal throughputga ega bo'lishga harakat qiladi.Latency bu 100ms va throughput esa 1k req/s .
Load oshishishiga moslashish uslublari
Asosiy usullar bu horizontal va vertical scaling, ba'zi dasturlar o'zgaruvchan bularga dynamic scaling bo'lishi mumkin ya'ni load oshganda ko'proq CPU bilan ishlab keyin yana pastga tushish . Bundan tashqari ba'zi dasturlar qo'lda scale qilinishi mumkin to'g'ri resurslar tanlash orqali. Dasturni qanday kengaytirish uning arxitekturasiga bog'liq bo'ladi hech qanday sehrli uslub yoq.
Unda oddiy bir dasturni qanday scale qilish mumkinligini ko'rib chiqamiz.
Dastur boshlanishi va foydalanuvchilar foydalanishi
Boshida hamma kodlarimiz bitta serverda turadi uni qaysidir hostingga qo'yishimiz mumkin va u bizga public IP address(144.156.60.34) beradi , ammo foydalanuvchilar bu ip addressni eslab qolishi qiyin va buni chetlab o'tish uchun saytga domain(something.com) sotib olamiz va uni IP addressga ulaymiz . Foydalanuvchilar websitedan foydalanish uchun domain terishadi va u chiqqandan so'ng click bosiladi shu payt , foydalanuvchi kompyuteri dns serverga domain nomi uchun IP address so'rab boradi va u shu domain joylashgan Ip addressni qaytaradi va foydalanuvchi shu orqali websaytga kira oladi.
Bizda foydalanuvchilar ko'payganidan so'ng bizga ko'proq serverlar kerak bo'ladi, shuning uchun biz web server va databazani bo'lamiz. Web server faqat so'rovlarga javob beradi , databaza ma'lumotlarni saqlaydi.
Qaysi databazani tanlash ?
Bizda databaza turlari bo'yicha 2 ta variant bor NoSQL va Relational databazalar . Relational databazalar ma'lumotlarni jadval(table) va qatorlar(row) ko'rinishida saqlaydi va ko'rsatadi va siz SQL joinlardan foydalangan holda jadvallarni birlashtira olasiz. Non-relational databazalardan eng mashhurlari bu MongoDB, Cassandra, DynamoDB, CouchDB ular 4 guruhga bo'linadi: key- value store, graph store, column store va document storelar. Odatda dasturchilar relational databazalar ishlatishadi ammo agar dasturda ushbu narsalar kerak bo'lsa NoSQL databazalar ishlatgan yaxshi :
Dasturda juda past latency bo'lishi kerak (key-value store cache sifatida
Ma'lumot strukturalanmagan va ular orasida bog'lanish kam yoki yo'q (MongoDB)
Siz ma'lumotlarni serializatsiya va deserilizatsiya qilishingiz kerak .
Juda katta miqdordagi ma'lumotni saqlashingiz kerak .
Databazani tanladik ammo bizda foydalanuvchi soni ko'paymoqda serverlar unga dosh berolmayapti ularni kengaytirishimiz(scale) kerak.
Vertical va Horizontal scaling
Vertical scaling bu scale up deb ham ataladi bu degani serverga ko'proq RAM yoki CPU yoki xotira berish orqali bo'ladi. Horizontal scaling esa scaling out deb atalad i va u dasturga ko'proq yangi serverlar qo'shish orqali bo'ladi. Agarda trafik juda kam bo'lsa vertical scaling yaxshi chunki u oson ammo unda chegaralar mavjud:
Hardware limit . bitta server uchun chegaralangan CPU va xotira .
Vertical scalingda fail over yoki redundancy mavjud emas , agarda server qulasa , saytga hech kim kira olmaydi.
Horizontal scaling katta dasturlar uchun juda yaxshi chunki vertical scalingda limitlar bor ammo biz xohlaganimizcha yangi serverlar qo'sha olamiz. Foydalanuvchi qachonki serverga ulanmoqchi bo'lsa load balancer orqali ularni serverlarga yo'naltiramiz.
Load balancer
Load balancer oldindan belgilangan load bo'yich serverlarga so'rovlarni taqsimlab beruvchi qism , bu orqali foydalanuvchilar faqatgina load balancerning public Ip addressini bilishadi va load balancer serverlarga bog'lanish uchun ularni bir xil tarmoqdagi private Ip addresslarini ishlatadi . Bu orqali biz 2-serverni qo'shdik va fail over hamda availability muammosini yechdik. Hozir agar bir service qulasa load balancer unga kelayotgan so'rovlarni boshqa serverlarga yo'naltiradi, agarda load juda ko'paysa yangi server qo'shishimiz mumkin va load balancer unga avtomatik tarzda so'rovlarni yangi serverga yo'naltiradi. Bu web server qismini ancha yaxshilaydi.
Database replication
Dasturimizning ma'lumotlarga javob beradigan qismida hozir redundancy mavjud emas va failoverni ham yechish kerak. Buni database replication orqali yechamiz buning asosiy usullaridan biri bu master/slave uslubi. Master hamma write(yozuv) so'rovlarni o'ziga qabul qiladi , slave ma'lumot nusxalarini olgan holda read(o'quv) so'rovlariga javob beradi.Hamma ma'lumot o'zgarishlar masterga boradi. Juda ko'p dasturlarda read(o'quv) writedan ko'p boladi bu degani bizga ko'proq slavelar kerak bo'ladi.
Data replication yaxshi tomonlari :
Yaxshi performance chunki bizda ko'p slave dblar bor va ular bir vaqtda ko'p so'rovlarga javob bera oladi.
Reliability(ishonchlilik) Agarda sizda bir server qulasa boshqasi uni o'rnini egallaydi va dastur davomiy ishlayveradi.
High availibility. Nusxalangan(replica) databazalar har xil joylashuvlarda bo'lishi mumkin bu ungan hamma tezda so'rov yubora olishini taminlaydi.
Agarda biror databaza o'chib qolsa nima bo'ladi = >bu failover :
Agarda faqatgina bitta slave bo'lsa va u o'chib qolsa ,read so'rovlar masterga vaqtinchalik yo'naltiriladi , muammo hal bo'lib slave yonganda yana unga yo'naltiriladi.Agarda slavelar ko'p bo'lsa so'rov boshqa ishlayotgan slavega yo'naltiriladi.
Agarda master o'chib qolsa , slave masterga aylanadi va write so'rovlarni qabul qila boshlaydi va yangi slave o'rniga qo'shiladi. Bu oddiy aytganda buni productionda amalga oshirish qiyin chunki ma'lumotlar hammasi masterdan slavega o'tmagan bo'ladi bu recovery scriptlar orqali qo'shiladi.
Agarda hammasini to'gri konfuguratsiya qilgan bo'lsak bizda yaxshi ishlayotgan sistema mavjud. Endi uni so'rovlarge tezroq javob berishini amalga oshirsak bo'ladi bu cache orqali bo'ladi.
Replication haqida ko'proq bilmoqchi bo'lsangiz ushbu maqolani o'qing. Link
Cache
Cache bu qayta ishlatish ko'p vaqt oladigan querylar natijalarini vaqtinchalik xotirada saqlab ularni tezda yetkazib beruvchi xotira(chunki odatda RAMda saqlaydi u diskdan ancha tezroq) . Hamma so'rovlarni databazaga uzatish o'rniga ularni ba'zilarini cachega yo'naltiramiz. Cachening yaxshi tomonlari performance oshiradi va databazaga bo'lgan loadni kamaytiradi(agarda to'g'ri ishlatilinsa) hamda uni alohida kengaytirish (scale) qilish mumkin.
Xo'sh bu qanday ishlaydi so'rov backendga keladi , backend uni kechda bor yoki yo'qligini tekshiradi , agar bo'lsa foydalanuvchiga ma'lumotni jo'natadi agarda bo'lmasa databazadan olib keladi va cachega qo'shib keyin jo'natadi , bu read through cache deyiladi . Uning boshqa variantlari ham bor bu ma'lumotni olish uslubiga bog'liq bo'ladi .
Qachon cachedan foydalanishimiz kerak va nimalarni hisobga olishimiz kerak :
Ma’lumot odatda ko'p o'qilib kam o'zgartirilsa
Expiration policy, ma'lumot malum vaqtdan so'ng o'chirib yuborilishi kerak , bu vaqt to'g'ri tanlanishi kerak agarda u tez bo'lsa databazada bari bir load kamaymaydi , agarda sekin bo'lsa foydalanuvchi no'to'g'ri ma'lumot oladi.
Consistency . Cache qo'shilgandan so'ng databaza va cachedagi malumotlar bir xil bo'lishi kerak. Databazadagi o'zgarishlar va cachega o'zgartirish kiritish birga bo'lmasa , inconsistentlik yuzaga keladi.
Bitta cache bu single point of failure bo'ladi bu degani shu qism o'chsa butun sistema ishlashdan to'xtaydi . Shuning uchun bir nechta data centerlardagi cachelar tavsiya etiladi.
Eviction policy. Cache ma'lumotlar bilan to'lganda unga yangi ma'lumot yozish uchun eskilari o'chirilishi kerak, bu uchun har xil usullardan foydalanish mumkin .LRU(least recently used) ishlatilganig eng uzoq vaqt bo'lgan bu eng mashhur usullaridan biri bundan tashqari , Least Frequently used eng kam ishlatilgan va First in First Outbirinchi yozilgan birinchi o'chiriladi , qaysi birini ishlatish bu sizning dasturingizga bog'liq.
CDN (content delivery network)
CDN bu dunyo bo'ylab joylashgan serverlar tarmog'i , undanstatic filelarni(image, video, js css) foydalanuvchilarga tezroq yetkazib berish uchun foydalaniladi. Foydalanuvchi saytga kirganida eng yaqin server unga shu sayt fayllarini uzatadi va buni CDN orqali amalga oshadi. CDN fayllarni ma'lum vaqtgacha saqlaydi TTLdanfoydalangan holda agar unda yo'q faylga so'rov kelsa haqiqiy turgan serverdan(AWS S3 bo'lishi mumkin) dan olib keladi.
CDNdan foydalanida nimalarni hisobga olish kerak:
Narx.CDN servis bo'lib boshqa kompaniyalar tomonidan yurigiziladi shuning uchun faqat ko'p ishlatilinadigan fayllarni unga joylash kerak.
Fayl ma'lum muddatdan so'ng o'chib ketishi kerak
CDN fallback. Agarda CDN ishlamasa foydalanuvchilar faylni haqiqiy serverda turganidan olishlari kerka.
Ma'lumotni expire muddatdan oldin o'chirish mumkin yoki versiyalarga limit qo'yish orqali o'chirish ham
Stateless web
Biz serverlarni horizontal scale qildik shunda foydalanuvchi sessiyalarini serverdan olib chiqib NoSQL databazaga qo'yish kerak, chunki stateful serverda har bir request oldingi serverga kelishi kerak. Shuning uchun serverlar stateless bo'lgani yaxshi bu scale qilishga oson bo'ladi.
Bizning saytimiz kengaymoqda
Saytimizga turli joyda mashhur bo'lib hamma unga kirmoqda va shuning uchun kengaymoqda . Biz endi ko'proq joylarni qo'llab quvvatlashimiz kerak bu uchun turli data centerlar bizga yordam beradi va saytning availabilitysini oshiradi. Data centerlar har xil joyda bo'ladi biri Americada bo'lsa boshqasi Xitoy boshqsi esa yevropa va ular shu mintaqada foydalanuvchilarga xizmat ko'rsatadi.
Data centers
Data centerdagi qiyinchilikalr:
Foydalanuvchini to'g'ri data centerga jo'natish
Data sinxronizatsiya. har bir data centerda o'zining cache va databazasi bo'ladi bularni consistent holatda saqlash kerak.
Testlash va serverga yuklash . Hamma data centerga tezda yangi versiyani yuklash uchun bu avtomatlashtirilgan bo'lishi kerak.
Message queue
Message queue bu ma'lumotlarni xotirada saqlaydigan chidamli (durable) komponent va u serverlar o'rtasida asinxron kommunikatsiya qilishga yordam beradi. _Bu xuddi bufferga o'xshaydi , ya’ni server qilishi kerak bo'lgan ishlarni o'zida saqlab turadi va serverlar o'rtasidagi bog'liqlikni olib tashlaydi_ .U publisher va consumer uslubida ishlaydi va ular alohida alohida scale qilinishi mumkin.
Asinxron kommunikatsiya bu uzoq vaqt ishlaydigan yoki muhim bo'lmagan vazifalarni backgroundda ishlatish.
Monitoring
Sayt kengaygan sari bizga monitoring juda kerak chunki u bizga sayt holati va bussiness haqida ma'lumot beradi:
Bussines haqida har xil ma'lumotlar yig'ish
Loglarni tekshirish va serverlar holatini ko'rib turish
Databaza va cachelarni performanceni kuzatib turish
revenue, kunlik va oylik active foydalanuvchilar sonini ko'rsatib turadi.
Database scaling
Saytimiz yanada yaxshiroq ishlashi uchun databaza scaling qilishimiz mumkin , buning 2 usuli bor vertical va horizontal . Vertical bu odatdagidek yangi resurslar qo'shish , bu single point of failurega olib keladi va juda qimmat. Horizontal scaling esa bu sharding orqali katta hajmdagi ma'lumotlarni bir necha kichik hajmdagi qismlarga bo'ladi . Bu yerdagi asosiy sharding key yaxshi tanlanishi va ma'lumotlar serverlar orasida teng taqsimlanishi kerak. Shardingdan keyin bir nech serverlar o'rtasida join qilish qiyin va buni denormalization orqali yechish mumkin.
Sharding haqida ko'proq bilish uchun bu maqolalarni o'qing.
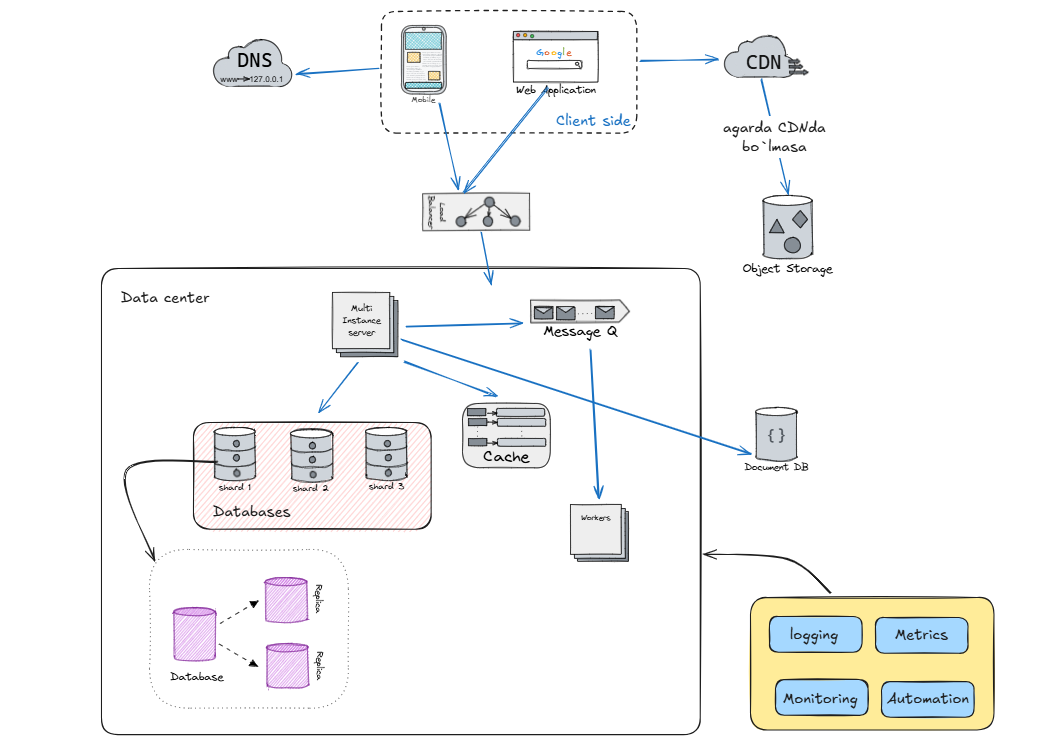
Xulosa
Xulosa qilib aytadigan bo'lsak dasturni har xil usulda kengaytirishimiz mumkin ekan. Serverlarni stateless holatda uslash horizontal scaling uchun yordam beradi. Har bir qismda nusxalar qo'shish dasturimiz doimiy ishlab turishiga yordam beradi. CDN va Cache ma'lumotlarni foydalanuvchilarga tezroq yetkazib berishga yordam beradi. Sharding orqali databazani mayda qismlarga bo'lish querylarni tezlashtiradi. Eng muhimi monitoring qilish xatolarni oldindan topish va hal qilishga yordam beradi.
Agarda maqola yoqqan bo'lsa chapak chaling (ko'p chalsayam bo'ladi ). Obuna bo'lishni unutmang ;)
Xato va kamchiliklar uchun uzr !!!
linkedin.com =>Ulug’bek Habibov | LinkedIn
telegram channel =>@habibov_ulugbek