CAP teoremasi nima? CP, AP va consistency turlari
Assalamu Alaykum bugun Distributed sistemalarni qurishda muhim bo'lgan CAP teoremasiniko'rib chiqamiz.
Ushbu maqolani boshlashdan oldin bu maqolani o'qishni tavsiya qilaman. Scalability
Xo'sh CAP teoremasi o'zi nima? Bizga qanday yordam beradi hozir shu savollarga javob berishga harakat qilaman.
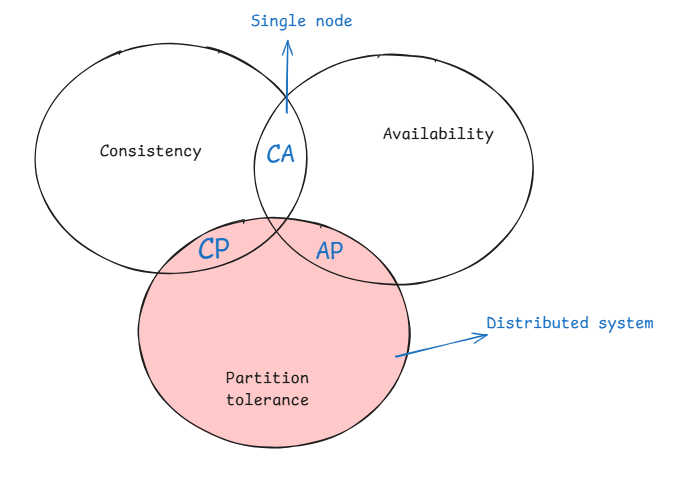
CAP teoremasi
Distributed sistemalarda siz quyidagi 3tadan faqatgina 2tasini bir vaqtda kafolat bera olasiz :
Consistency — Har bir o'quv(read) so'rovi eng oxirgi ma'lumotni yoki xatolik olishi kerak , qaysi node bo'lishidan qa'tiy nazar.
Availability — Har bir so'rov javob olishi kerak , eng oxirgi ma'lumotlarni o'z ichida olishi kafolatlanmagan bo'lsa ham.
Partition Tolerance — Sistema yoki dastur tarmoqdagi uzilish bo'lgan yoki ba'zi nodelar o'chib qolgan taqdirda ham ishlashda davom etishi kerak.
Network partition — bu distributed sistemada qismlar bir biri bilan aloqani yo'qotishi (sabab tarmoq ishlamasligi yoki boshqa taraf o'chib qolganligi bo'lishi mumkin).
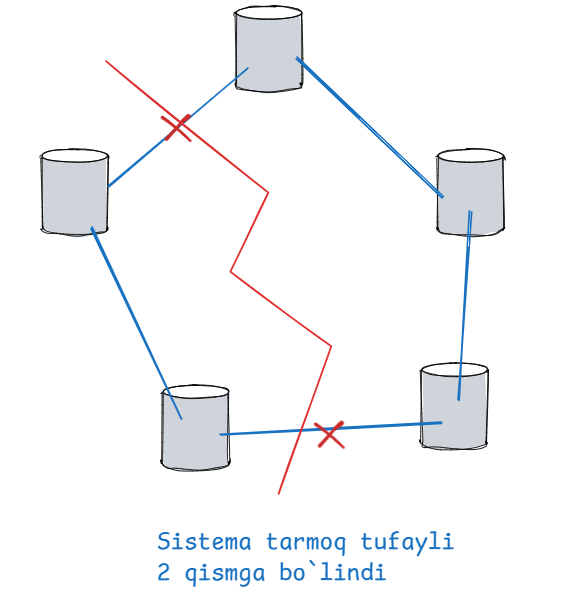
Note: Tarmoq(network) ishonchsiz , shuning uchun partition tolerance distributed sistemada bo'lishi kerak. Shuning uchun dasturimizga consistency va availability o'rtasidan birini tanlashimiz kerak bo'ladi (tradeoff) .
Distributed sistemalarda allaqachon partition mavjud(chunki ular bir nechta kompyuterdan tashkil topgan va tarmoq ishonchsiz) shuning uchun C va A da birini tanlashimiz kerak.Agarda sistema consistencyni ustun qo'ysa sistema partition hal qilinmaguncha unavailable bo'ladi. Availabilityni ustun qo'ysa foydalanuvchiga xato ma'lumot ko'rsatishi kerak bo'ladi.
Distributed system haqida maqola. Distributed system nima ?
Tarmoqda uzulish bo'lganda shuni qilishimiz kerak:
Consistency uchun ma'lumotlarni ishlashdan to'xtash
Yoki xato ma'lumot jo'natishga rozi bo'lish.
Keling har bir juftlik bizning sistemaga nimalar olib keladi ko'rib chiqamiz.
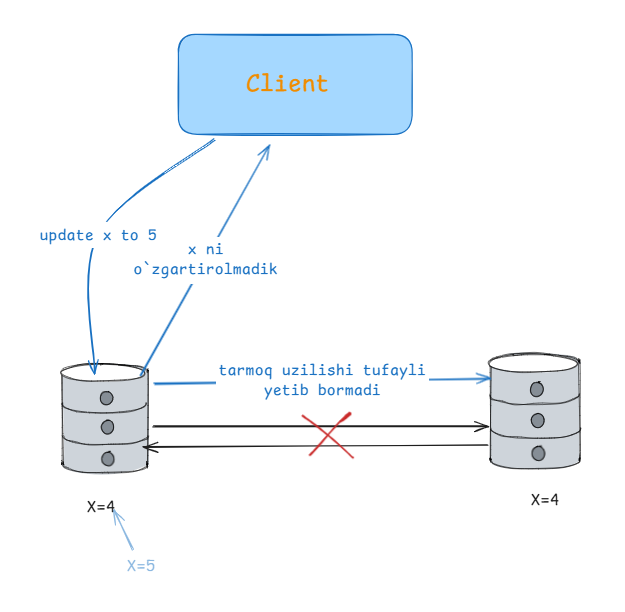
CP — consistency va partition tolerance
CPga ega bo'lgan tizimda bo'linib qolgan sistema qismidan javob olishni kutish kerak va natijada so'rov timeoutga tushishi mumkin. CP sistema agarda business birgalikdagi bo'lishi kerak bo'lgan amallardan iborat bo'lsa (atomic read va write) yaxshi tanlov hisoblanadi.
AP — availability va partition tolerance
AP sistemada javob sifatida nodeda tayyor versiyadagi ma'lumotni beradi qaysi nodeda bo'lsa ham va bu oxirgi versiya bo'lmasligi mumkin. Yozuv(write) so'rovlari partition to'g'rilangandan keyin hamma nodega yetib kelguncha vaqt oladi.
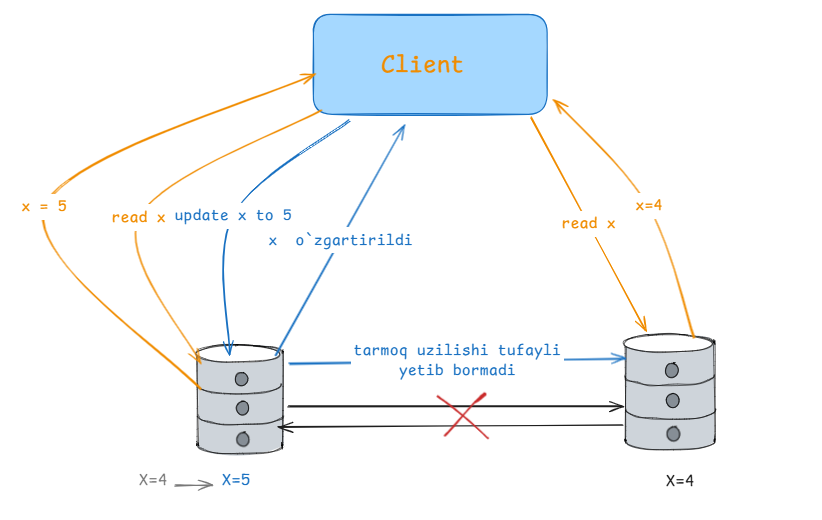
AP har qanday external xatoliklar bilan ham ishlashi yoki eventual consistency bilan ishlay oladigan bizneslar uchun juda qulay.
CA — consistency va availability
CA sistema faqatgin bitta kompyuter yoki serverdan iborat bo'lgan sistema qila oladi chunki unda avtomatik partition bo'lmasligi aniq.
Qachon C va A o'rtasida tanlov qilishimiz kerak?
Consistency va Availability orasidagi tanlov busoftware trade offdeyiladi. Siz netwrok partition bo'lgan paytda bu tanlovni qilishingiz kerak va u sizning qo'lingizda .Network outages har doim bo'ladi vaqtinchalikga yoki uzoq muddatga buni siz boshqara olaymiz.
CAP faqatgina qaysidir holatlarda C yoki A ni tanlashni taklif qiladi . Bu holatlarni favqulotda holatlar deb ataylik . C va A 100% kafolatlanganda bittagina inconsistent read yoki xatolik bularni yoq qiladi . Ammo favqulotda holatgacha system ham consistent va available bo'la oladi.
Consistency uchun misollar :
Ticketing platform chiptalarga buyurtma berayotganda
Inventory system
Financial systems
Availability uchun misollar :
Social media
Yelp
Streaming service(Netflix)
Eng asosiy savol bu agarda foydaluvchi eng oxirgi ma'lumotni ko'rmasa va bu sistema uchun halokatli bo'lsa sizga strong consistency kerak.
Sistema dizayniga bu qanchalik ta'sir qiladi ?
strong consistency:
— distributed transaction implimentatsiya qilish (databaza va cacheda bir xil ma'lumot bo'lishi kerak)
— Cheklangan bir nodeda ishlash
— Serverlar o'rtasida consensus o'rnatish muammosi
— Yuqori latencyni qabul qilish
Tools:
— PostgresSQL
— Spanner
— Stong consistency modedagi NoSQL(DynamoDB)
Availability:
— Bir nechta replicalardan foydalanish
— Eventual consistency sistema uchun yetarli
Tools:
— DynamoDB (multi a-z zone)
— Cassandra
Advanced Part!
Sistemaning har xil qismlarida har xil talablar bo'lishi mumkin. Masalan Ticketing platformasini olaylik u CRUD operatsiyalari uchun availability kerak ammo chiptalarni buyurtma qilishda consistency kerak bo'ladi.
Bundan tashqari e-commerceda omborda bo'lmagan mahsulot sotilmasligi kerak ya'ni foydalanuvchiga sotuvda deb chiqmasligi kerak bu consistencynitalab qiladi , ammo PM yoki PO mahsulot yo'q deb ko'rsatishdan ko'ra uni bekor qilib pulni qaytarish biznes uchun qulay desa biz availabilitynitanlashimiz kerak bo'ladi.
Keling Consistency va Availability turlarini ko'rib chiqaylik.
Consistency patterns
Bizda bir xil ma'lumotning bir necha nusxasi bo'lganiligi uchun ularni bir xil holatda saqlash va foydalanuvchiga ko'rsatish , muammosiga duch kelamiz. CAP theoremasida aytganidek har bir read eng oxirgi versiyadagi malumotni ko'rishi kerak.
Weak consistency
Yozish(write) amalga oshirilgandan keyin , o'quv(read) uni ko'rishi yoki ko'rmasligi mumkin. Bu uslub memcachedda ko'rishingiz mumkin. Weak consistency real time dasturlarda yaxshi ishlaydi masalan, video chat va real time multiplayer o'yinlar. Masalan siz video aloqadasiz va bir necha soniya uzilib qoldi va aloqa qayta tiklanganda siz oldingi sekundlarda nima gapirilganini eshitolmaysiz va bu muammo emas.
Eventual consistency
Yozish(write) amalga oshirilgandan keyin , o'quv (read) uni ma'lum muddatdan so'ng ko'radi (odatda millisekundlar). Ma'lumot asinxron tarzda replicalarga o'tkaziladi.
Bu uslub DNS system va emaillarda ishlatilinadi. Eventual consistency high availablity talab qilinadigan sistemalarda yaxshi tanlov.
Strong consistency
Yozish(write) amalga oshirilgandan keyin darhol o'qish so'rovlari (read) ma'lumotni ko'radi . Ma'lumotlar sinxron tarzda replicalarga o'tkaziladi.
Bu uslub fayl sistemalar va RDBMSlar ishlatadi . Strong consistency transaction kerak bo'ladigan sistemalarda yaxshi tanlov.
Strong vs Eventual consistency haqida to'liq maqola.
Casual consistency
Casual consistency bu yozuvlar o'qilganda bir biriga aloqador ma'lumotlar hamma nodelarda bir xil tartibda o'qilishi kerak. Masalan chatda Qayerdasan ?degandan so'ng manzil keladi ularni o'rni almashib ketmasligi kerak.
Read your writes
Bu consistencyda siz o'zingiz yozgan yozuvlarni ko'ra olishingiz kerak . Masalan account ma'lumotarini o'zgartirdingiz va sahifani qayta yuklasangiz ma'lumotlar eski chunki siz boshqa serverga yo'naltirilgan bo'lishingiz mumkin . Read your writesda esa har qanday holatda ham siz o'zingiz yozgan ma'lumotlarni keyingi readlarda o'qiy olishingizni taminlaydi .
Quorum Uslubi
Quorumga asoslangan uslubda guruhda ovoz berish uslubi orqali consistency va fault tolerance taminlanadi .
Bu qanday ishlaydi sizda 5 ta service bor yozuv(write) so'rovi kelganda 5ta servicega write yuboriladi va 3 ta service writeni muvaffaqiyatli yozdik desa foydalanuvchiga ma'lumot yozildi deb javob boradi . O'qishga so'rov kelganda ham 5 ta servicega so'rov yuboriladi va 3 tasidan so'rov kelganda birlashtirib qaytariladi.Oxirgi ma'lumot foydalanuvchiga borganini qanday bilamiz desangiz ? Bizdagi 3ta serverda yangi ma'lumot bor va bizda 5 ta server bor read so'rovi kelganda 3tasidan natija kelganda , _hech bo'lmasa bitta oxirgi ma'lumot bor serverdan ma'lumot keladi va bu consistency ni ta'minlaydi._
R +W > Server soni bundagi Read yoki Write muvafaqiyatli kelishi kerak bo'lgan serverlar sonini o'z xoxishga qarab o'zgartirish mumkin. Masalan read tez bo'lishi uchun readda kam serverlar soni bo'ladi ammo write buni kompensatsiya qilish uchun ko'p serverlarga ma'lumot yozishi kerak va bu ko'p vaqt olishi va foydalanuvchi kutib qolishi mumkin.
System Designda consistency va availability orasida balans kerak tepadagi Quorumga asoslanga distributed sistemalarda ma'lumotlarni saqlashda qaysi ma'lumotni saqlash kerakligini aniqlash kerak bunga consensuslar yordam beradi . Paxosva Raftshunaqa mashhur algoritmlardan biri.
Linearizibility
Bu consistency modelda ma'lumotlar faqatgina bir nusxadadek ko'rinishi kerak foydalanuvchiga. Foydalanuvchi get so'rov qilganda keyingi natijalar oldingi natijalarga qarshi bo'lmasligi kerak va serverga kelgan ketma-ketlikda ko'rsatilishi kerak. Masalan ikki kishi fudbol o'yini natijasini tekshirayotganda biriga o'yin tugadi deb kelib 2-chisiga qo'shimcha vaqtlar ketmoqda deb ko'rsatmasligi kerak.
Availability patterns
High availabilityni taminlash uchun bizda 2 ta uslub bor :fail-over va replication.
Fail-over
Active-passive
Active-passive fail-overda, active va passive serverlar orasida serverlar ishlayotganini bilish uchun so'rovlar uzatilib turiladi . Agarda bu so'rovlar uzilib qolsa , passive server active serverning IP address o'rniga o'tib ishni davom ettiradi.
Downtime vaqti passive serverning allaqachon 'hot' yani ishga tushgan holati yoki uni 0 dan ishga tushish vaqtiga bog'liq bo'ladi. Faqatgin active server traffic bilan ishlaydi. Active-passive yana master-slave fail over deb ham ataladi.
Active-active
Active-active holatda ikkala server ham traffic bilan ishlayotgan bo'ladi va load ikkalasi orasida bo'linadi.
Agarda server public bo'lsa DNS ikkalasining ham IPsini bilishi kerak, agarda internal bo'lsa dastur logikasi bular haqida bilishi kerak bo'ladi.
Active-active failover master-master failover deb ham ataladi.
Failover yomon tomonlari :
Fail-over qo'shimcha hardware va murakkablik qo'shadi.
Balkim data yo'qolishi mumkin, master o'chishidan oldin yangi ma'lumotlarni passive serverga o'tkazishga ulgurmasligi mumkin.
Replication
Replication haqida ko'proq bilib olish uchun maqola.Database Replication
Availability raqamlarda
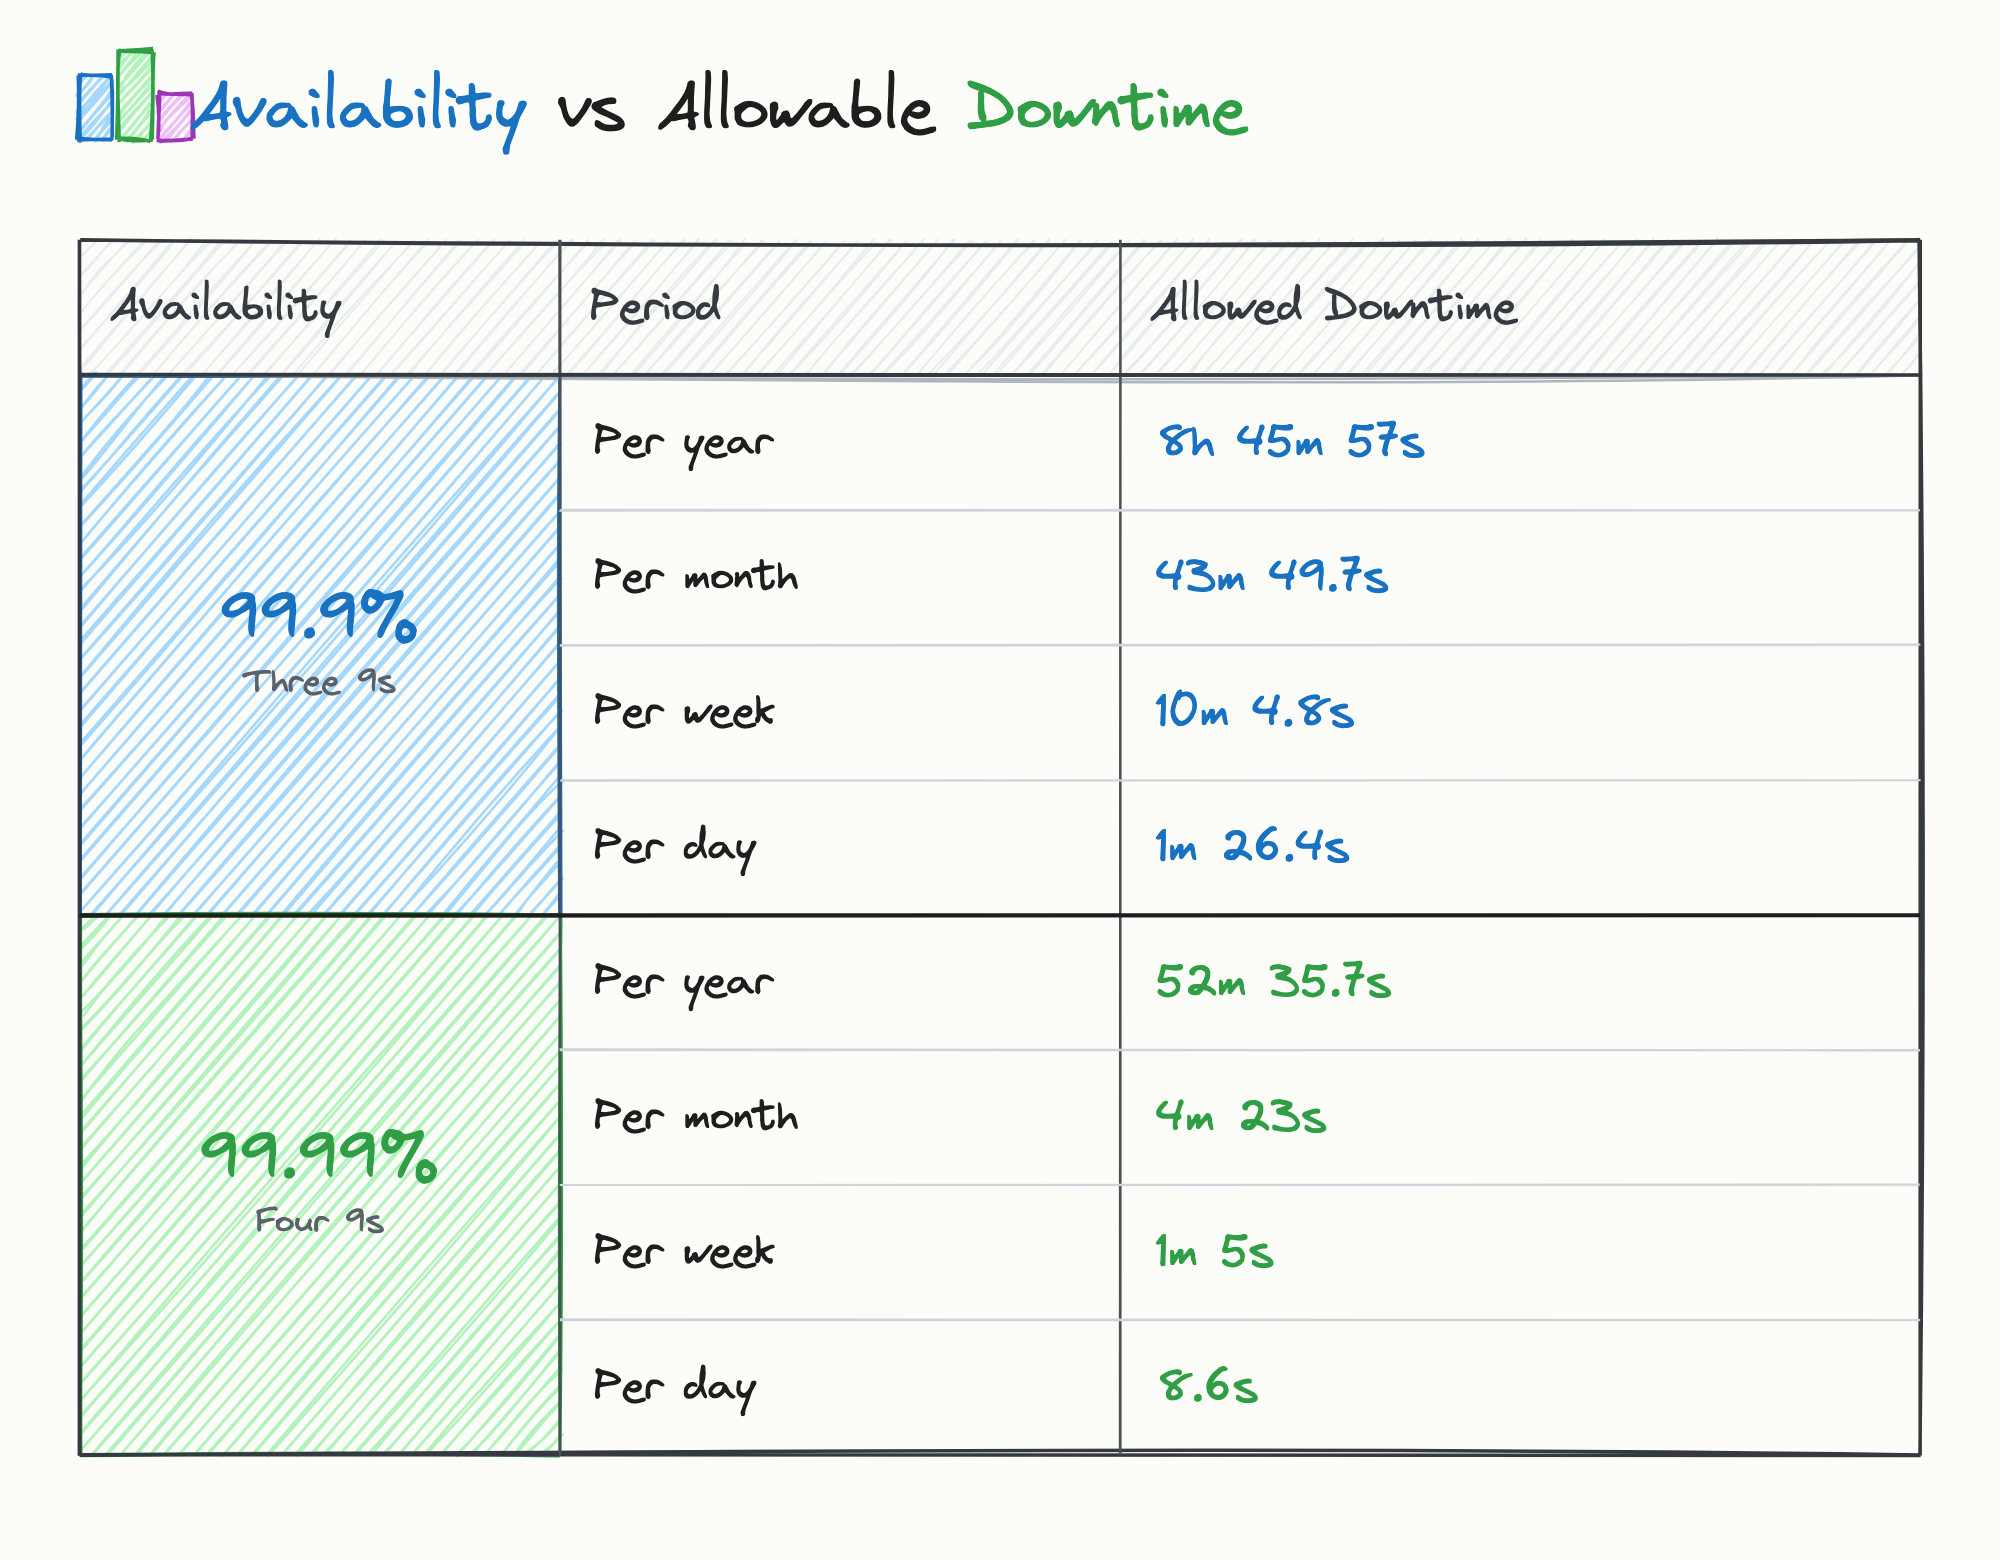
Availability odatda raqamlarda servisning ishlab turish vaqti foizi bilan hisoblanadi . Availability odatda 9larda ifodalanadi 99.99 % 4 ta 9 deb ataladi.
Availability parallel va ketma-ket holatda
Agarda service bir nechta komponentdan tashkil topgan bo'lsa ularni, ketma-ket yoki parallel holatdaligi servisning ishlash vaqtini aniqlashga ta'sir qiladi.
Ketma-ket holatda
Umumiy availability kamayadi chunki har biri o'chib qolishi sistema to'xtashiga sabab bo'lishi mumkin. Bular masalan Load Balancer → Server → DB . Agarda flowga cache qo'shilsa availability yanada tushadi , chunki natija har bir komponent ishlashiga bog'liq.
Availability (Total) = Availability (Number1) * Availability (Number2) Agarda ikkala serverda 99.9 % availability hamda ketma-ket ulangan bo'lsa ularning umumiy availabilitysi 99.8% bo'ladi.
Parallel holatda
Umumiy holatda availability oshadi chunki biri ishlamasa ikkinchisi ishlab turadi va bu umumiy availability oshishiga sabab bo'ladi. Bu holatda ular replica qo'shish hisoblanadi masalan ko'proq server qo'shish , database replication buning natijasida availability oshadi.
Availability (Total) = 1 - (1 - Availability (Number1)) * (1 - Availability (Number2)) Agarda ikkala serverda 99.9 % availability hamda parallel ulangan bo'lsa, umumiy availability 99.9999% bo'ladi.
CAP dan tashqari: PACELC
CAP bu asosiy teorema bo'lsa ham u hamma holatlarni o'z ichiga olmaydi.
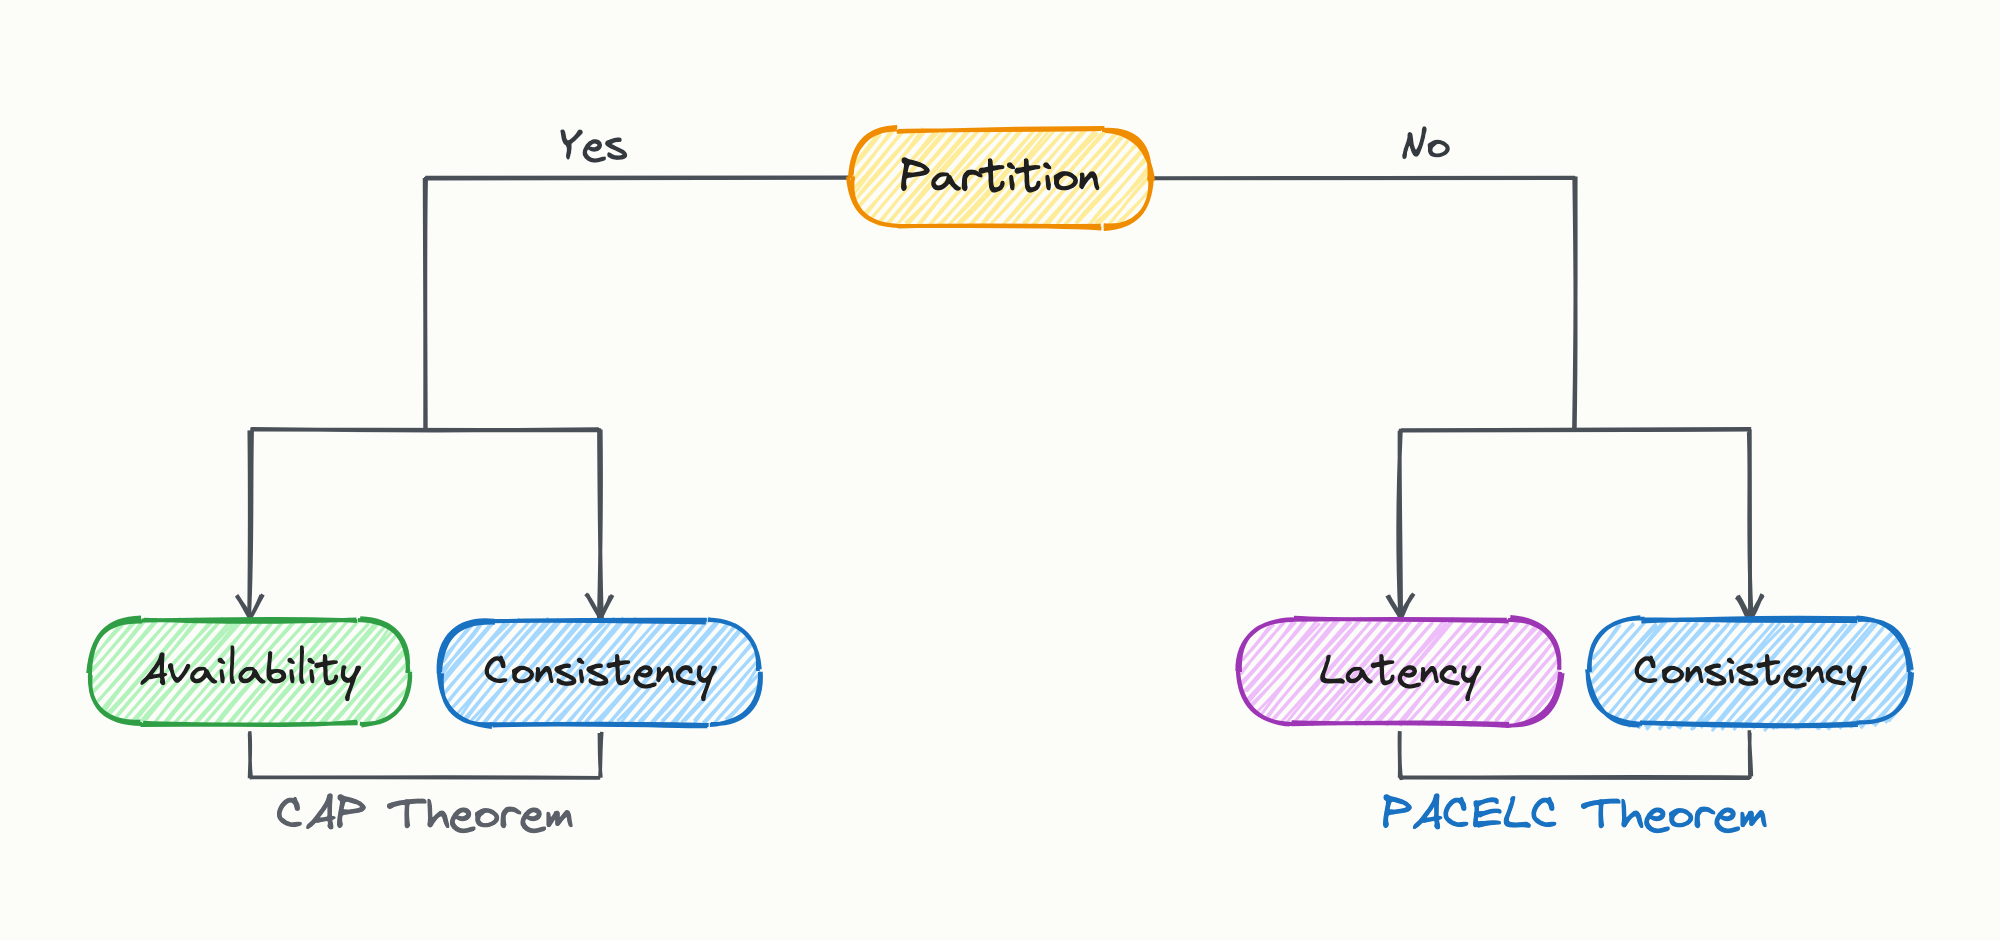
Daniel Abadi **PACELC** teoremasini taklif qilgan , chunki latency va consistency distributed sistemaning qo'shimcha xususiyatlari. PACELC teoremasi bunday :
Agarda sistemada partition(qismga bo'lingan) bo'lsa trade off availability va consistency o'rtasida bo'ladi(A va C).
Agarda bo'lmasa trade off latency va consistency orasida bo'ladi. Ya'ni sinxron yoki asinxron ma'lumot o'tkazishda.
Bu teorema agarda sistema to'g'ri va biz xohlagandek ishlayotgan paytida ham latency va consistency orasida trade off qilishi kerakligini takidlab o'tadi.
Xulosa
Xulosa qilib aytadigan bo'lsak CAP teoremasi bizga distributed sistema qurilayotgan payt talablarga qarab qaysi qismni tanlash kerakligi o'rganishga yordam beradi. CAP teoremasidan to'g'ri foydalangan holda tez va xatolikga chidamli bundan tashqari consistency va availability , partition tolerance orasida muvozonatlashgan arxitektura qurish mumkin.
Agarda maqola yoqqan bo'lsa chapak chaling (ko'p chalsayam bo'ladi 50 tagacha). Obuna bo'lishni unutmang ;)
Xato va kamchiliklar uchun uzr !!!
linkedin.com =>Ulug’bek Habibov | LinkedIn
telegram channel =>@habibov_ulugbek